

 Скачать документ
Работа с JSON в СУБД РЕД База Данных на примере демонстрационной БД SALES
Введение
SALES — демонстрационная учетно-аналитическая база данных по учету продаж канцтоваров, которая регулярно получает новые данные извне, из разнообразных источников.
В этом документе рассмотрено:
- Как создать демонстрационную базу данных SALES и таблицы нужной структуры.
- 4 варианта решения задачи получения, разбора и загрузки внешних данных в формате JSON.
- Как из простой программы на языке Go подключиться к базе данных РЕД База Данных, разобрать данные в формате JSON и пакетно загрузить их в базу данных.
- Как СУБД РЕД База Данных 5 поддерживает работу с JSON-данными, и как использовать SQL JSON для их обработки.
- Как работать с хранимыми процедурами, представлениями (view) и триггерами для более эффективного решения задач на сервере.
- Как пользоваться SQL для получения выборок, контрольных и аналитических отчетов.
- Что делать в случае сбоев и возникновения ошибок.
Для самостоятельного повторения запросов и операций, описанных в пособии, потребуется:
- Компьютер под управлением любой ОС из списка:
- Windows (10 или 11) 64-bit или
- Linux 64-bit. Годится практически любой из имеющихся вариантов, рекомендуется РЕД ОС 8
- Необходимо наличие установленной и сконфигурированной СУБД РЕД База Данных версии 5.0+. Если позволяет размер имеющейся памяти и характеристики клиентского компьютера, СУБД можно установить прямо на него, скачав соответствующий платформе дистрибутив. В случае СУБД на удаленном сервере, потребуется доступ к СУБД и файловой системе сервера. Как вариант, можно воспользоваться образом Docker-контейнера с установленной СУБД.
- Для создания БД и выполнения скриптов и запросов, описанных ниже, потребуется средство запуска SQL.
Технически будет достаточно штатного CLI инструмента из дистрибутива ISQL, но значительно нагляднее и комфортнее работать в кроссплатформенном графическом инструменте “РБД Эксперт”, который можно скачать с сайта компании РЕД СОФТ и установить на свой компьютер.- Для желающих повторить сборку приложения-загрузчика также потребуется установить компилятор и инструменты языка Go (Golang), если они ранее не были установлены.
Описание структуры демонстрационной БД
Структура БД очень проста. О каждом случае продажи товаров в таблице SALE_RECORDS сохраняется запись. В таблице CUST сохраняется запись с данными о каждом уникальном покупателе, приобретшим товары. Покупатель может совершить покупки много раз. В рамках одной покупки может быть приобретено несколько товаров - по различным ценам и в разных количествах - и записи об этом сохраняются в таблице ITEMS. Каждая запись из ITEMS ссылается на строку о продаже, в рамках которой они были приобретены. В свою очередь, каждая запись о продаже имеет ссылку на запись из таблицы CUST о покупателе, который эту покупку совершил.
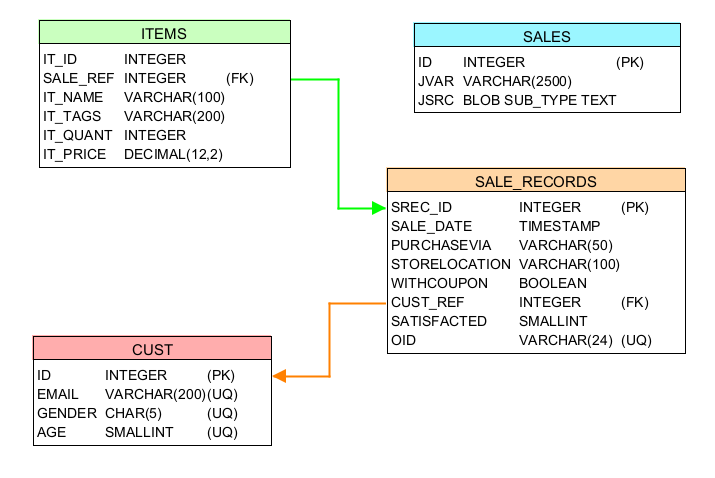
Таблица SALES была создана как буфер для временного хранения порции новых внешних данных. Далее мы увидим, что есть способ обойтись без нее.
Создание демонстрационной БД SALES и таблиц
Исходные тексты скриптов и SQL запросов находятся в архиве Scripts.7z
Windows
Запустите окно командной строки CMD
Win-R CMD <Enter>Перейдите в каталог с туториалом и выполните команду.
set ISC_PASSWORD=masterkey
После этого можно будет не указывать пароль при запуске утилиты командной строки ISQL из дистрибутива РЕД База Данных.
Запустите утилиту ISQL. Выполните следующую команду CREATE DATABASE
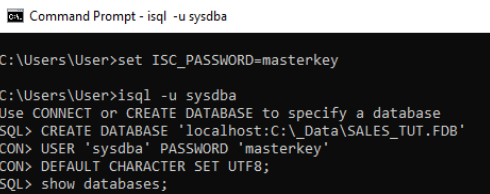
вместо localhost: укажите имя и порт вашего сервера СУБД, например: redbase:3050, а вместо С:\_Data\ - путь к каталогу на диске сервера БД, куда будет помещен файл БД SALES_TUT.FDB
Для проверки выполните команду
SHOW DATABASE;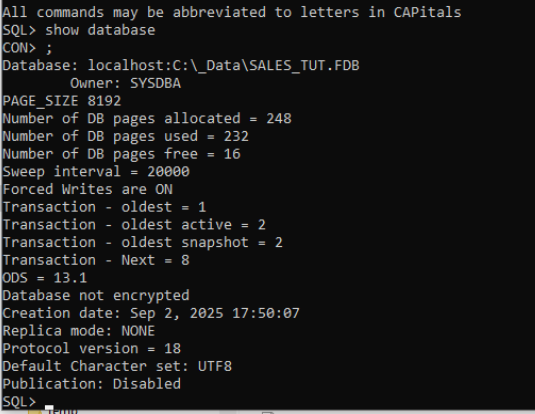 успешное создание БД
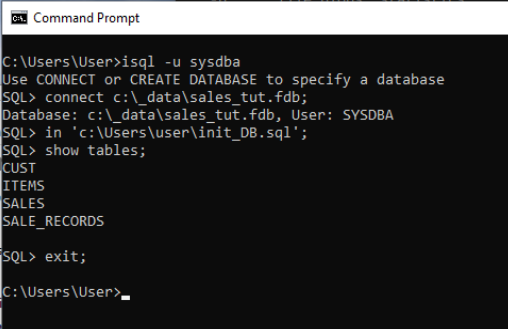
Затем выполните прилагающийся к туториалу скрипт init_DB.sql
Linux
Подготовка базы данных в Linux показана на примере использования РБД Эксперт.
Перед созданием БД подготовьте папку на сервере СУБД, в которой будет размещаться файл БД. Владельцем папки необходимо сделать пользователя reddatabase. Если этот каталог находится в общей файловой системе, необходимо иметь достаточные привилегии или воспользоваться sudo.
Например, следующим образом в терминале пользователя:
sudo mkdir /db
sudo chown reddatabase: /db
Установите РБД Эксперт, если он отсутствует на компьютере, и запустите его. Установка РБД Эксперт подробно описана на сайте РЕД СОФТ
Для создания БД используется кнопка "Создать базу данных" на вкладке "Браузера баз данных" или соответствующий пункт меню "База данных/Создать базу данных".
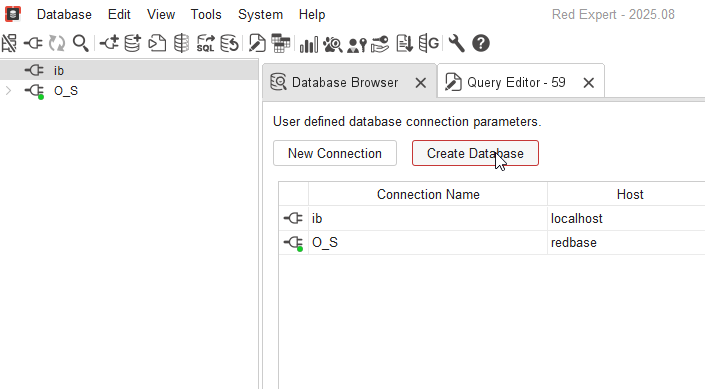
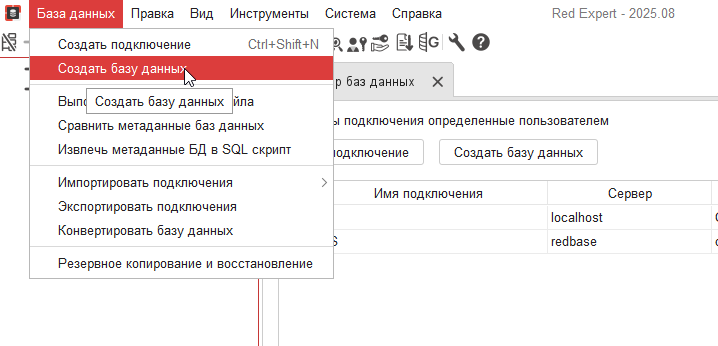 Далее необходимо заполнить все обязательные поля. Опишем назначение некоторых полей этой вкладки:
-
Имя подключения- произвольное имя, чтобы обозначить подключение в дереве объектов слева. -
Имя сервера- доменное имя, алиас или IP адрес сервера БД, к которому мы будем подключаться, чтобы создать БД. Для локального компьютера достаточно оставить значение по умолчаниюlocalhost. -
Порт- номер коммуникационного порта для связи с сервером БД. Стандартное значение 3050, но может быть изменено админом СУБД -
Файл БД- файл на сервере БД.Обратите внимание!
Это файл, к которому будет подключаться сервер СУБД, а не РБД Эксперт. Если в поле
Имя серверауказан удаленный сервер, то с локального компьютера к этому файлу может не быть доступа. Другими словами, этим значением мы лишь сообщаем серверу, какой файл использовать для БД, но не работаем с этим файлом на нашем компьютере. Это объясняет, почему права на каталог с БД должны быть предоставлены пользователю reddatabase, от которого работает сервер СУБД РЕД База Данных. -
Пользователь- имя пользователя, от имени которого будет установлено подключение к серверу и кто будет являться владельцем этой БД. sysdba - это имя суперпользователя, который всегда существует в БД и имеет все права.
Создавать новых пользователей и управлять ими также можно с помощью РБД Эксперт. -
Пароль- пароль пользователя, который был указан при его создании. Пароль пользователя sysdba указывается при установке сервера СУБД и по умолчанию для тестовых целей равенmasterkey. -
Сохранить пароль- можно выставить, чтобы не вводить пароль для этого подключения постоянно. Однако это может нарушать принятые правила безопасности.
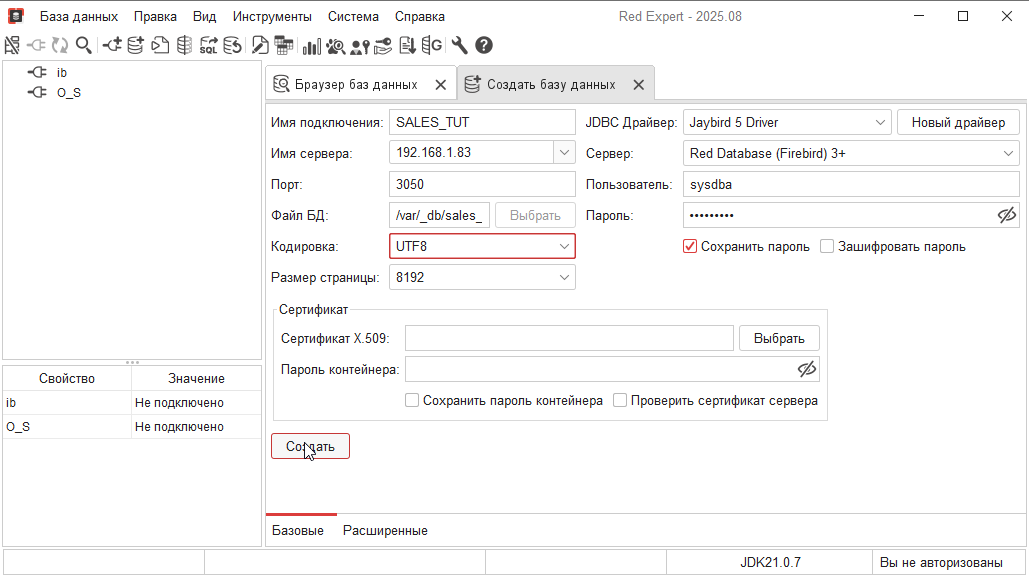
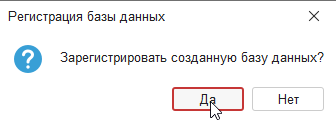
После нажатия кнопки "Создать", запрос создания БД будет отправлен на сервер и, если не будет ошибок, БД будет успешно создана, а РБД Эксперт предложит ее зарегистрировать в дереве объектов.
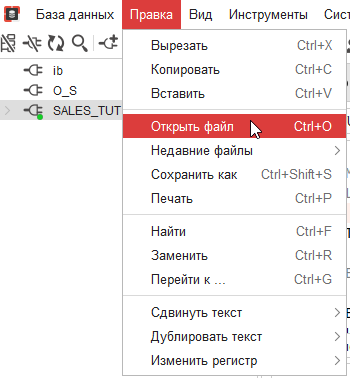
Откройте прилагающийся к туториалу скрипт init_DB.sql. Для этого выберите пункт меню “Открыть файл” и укажите этот скрипт в ваших каталогах.
Скрипт будет загружен в редактор запросов SQL РБД Эксперта.
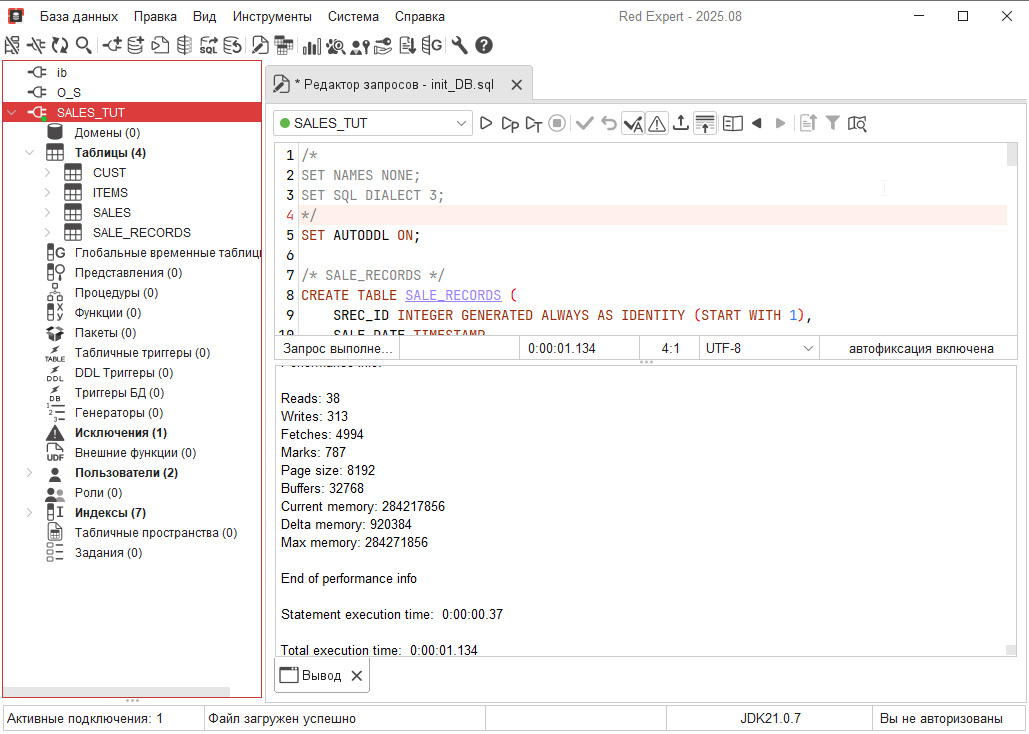
Нажмите первую кнопку (с треугольником острием вправо) на панели в верхней части редактора запросов или клавишу F9. Если не возникнет никаких ошибок, демонстрационная БД SALES и необходимые таблицы будут созданы. Убедитесь в этом, раскрыв дерево соединения слева в окне РБД Эксперт.
4 варианта загрузки JSON из внешних источников
SALES — демонстрационная учетно-аналитическая база данных по учету продаж канцтоваров, которая регулярно получает новые данные извне, из разнообразных источников. Подавляющее большинство данных из внешней системы приходит в виде отчетов из системы на основе NoSQL СУБД MongoDB в формате JSON — “родного” представления данных в MongoDB.
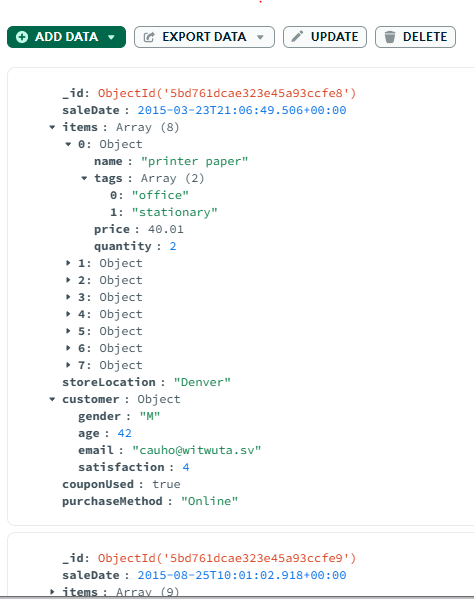
Входная порция внешних данных представляет собой файл, содержащий JSON массив из большого количества JSON объектов сложной структуры. Каждый объект соответствует одной записи о продаже. Формат JSON позволяет поместить в один объект всю имеющуюся информацию о продаже, даже ту ее часть, которая не будет использована в аналитической БД.
Задача состоит в том, чтобы разобрать каждый объект из массива входных данных и поместить соответствующие значения в поля связанных записей трех таблиц аналитической системы. Отсутствующие записи таблиц SALE_RECORDS и ITEMS необходимо добавить.
В РЕД База Данных версии 5 массивные внешние данные могут быть загружены в БД несколькими способами.
- Импорт из файла в формате с разделителями (CSV) или файла из записей с полями фиксированной длины.
- Выборка из таблицы с использованием внешних файлов - все ее строки могут помещаться в отдельный текстовый файл, находящийся вне базы данных.
- Загрузка с клиентского компьютера с помощью утилиты-загрузчика.
- Так как JSON-данные в РЕД База Данных хранятся в виде полей Blob, можно воспользоваться встроенными средствами работы с внешними файлами Blob.
Импорт из файла с полями фиксированной длины или в формате с разделителями (CSV)
В данной задаче передаются данные в формате JSON, которые явно не являются полем с фиксированным размером. JSON не имеет выраженных колонок, хотя разные свойства объектов или элементы массивов могут разделяться запятыми. Данные JSON объектов могут располагаться на нескольких строках во входном текстовом файле. Представить входной набор, как файл CSV с единственным строковым полем, нельзя из-за правил применения двойных кавычек в формате CSV (вернее, это потребует внесения множества изменений в каждую запись).
Поэтому способ 1 не подходит.
Выборка из таблицы с использованием внешних файлов
СУБД РЕД База Данных поддерживает два формата внешних файлов: формат "строк с фиксированной длиной" и .csv формат. Столбцы таблицы, которые хранятся во внешних файлах, могут быть любого типа данных, кроме BLOB. Недопустимо также использование массивов с любым типом данных.
Следовательно, приходится отказаться от способа 2 по аналогичным способу 1 причинам.
Загрузка с клиентского компьютера с помощью приложения-загрузчика
В первом и втором способах новые данные сперва перемещаются на сервер БД и затем централизованно обрабатываются встроенными программными инструментами СУБД.
С помощью утилиты-загрузчика объемная порция внешних данных в формате JSON может быть быстро перенесена на сервер БД или загружена в таблицу. Однако в штатной поставке СУБД готовой такой программы нет и придется ее написать.
В зависимости от источника данных и вида носителя, на котором новые данные доставляются в демонстрационную БД, требования к программе-загрузчику существенно разные. Например, можно создать такое приложение, которое выполнит весь разбор и логическую обработку порции новых данных на клиентском компьютере, а в БД запишет уже результат. Как другой вариант, это может быть простая по функциям программа для передачи новых данных “как есть” и запуска обработки их на сервере, как в предыдущих способах.
Загрузка с использованием встроенных средств работы с внешними файлами Blob
Файловые блобы хранятся в каталогах, настраиваемых в файле directories.conf. Они управляются тремя системными функциями: CREATE_FILE, READ_FILE, DELETE_FILE. См. руководство администратора в документации
Файл directories.conf Находится в том же каталоге, куда была установлена СУБД РЕД База Данных. В данном файле задаются алиасы каталогов, в которых хранятся:
- файлы, заполненные BLOB-данными;
- файлы табличных пространств.
Структура файла:
database
 {
   blobs
     {
       <алиас_каталога_для_BLOB> = <существующий/путь/к/каталогу>
       ...
     }
   tablespaces
     {
       <алиас_каталога_для_tablespace> = <существующий/путь/к/каталогу>
       ...
     }
 }
Например, для СУБД на ОС Windows в него были внесены следующие изменения:
   blobs
     {
       blob_dir = \_data\blobs
     }
Затем в этот каталог был помещен файл с входными данными:
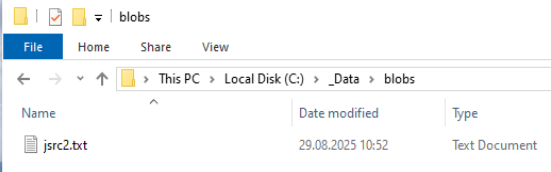
Теперь данные в виде BLOB можно получить запросом:
SELECT READ_FILE('BLOB_DIR/JSRC2.TXT') FROM RDB$DATABASE;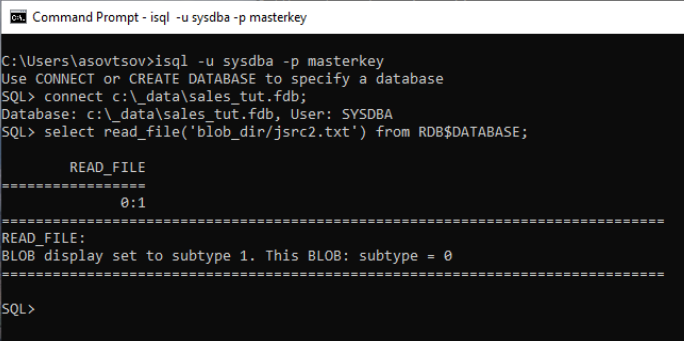
и применить к ним SQL/JSON.
Этот вариант также будет рассмотрен далее.
Краткое введение в SQL JSON
JSON (JavaScript Object Notation) — это текстовый формат для хранения и передачи структурированных данных. Стандарт основан на синтаксисе объекта в JavaScript, но не привязан к нему. Этот формат состоит из следующих элементов и их комбинаций:
- «Объект» — пара или набор пар ключ‑значения, заключенные в фигурные скобки,
- «Массив» — состоит из упорядоченного списка значений, заключённых в квадратные скобки,
- «Скаляр» — представление простых значений, таких как строки, числа или логические значения,
- «null» — отсутствие значения.
Пример
{
    "responded": [{"code":404},
                  {"code":418},
                  {"ok":false},
                  null ],
    "element": "button"
}
СУБД РЕД База Данных 5 поддерживает утвержденный ISO стандарт SQL/JSON ISO/IEC TR 19 075–6, который описывает функционал для работы с JSON данными из SQL.
Стандарт SQL/JSON включает различные функции для генерации, запроса и валидации данных в JSON:
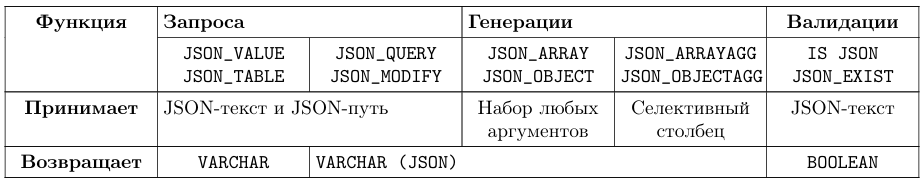 Функции генерации используются для создания JSON данных (объектов или массивов) на основе значений SQL. Функции запроса позволяют извлекать данные из JSON по выражению пути. Из результата убираются пробелы, переносы на новую строку и символы табуляции. Функции валидации используются для проверки правильности JSON данных.
Существуют следующие функции запроса:
- JSON_VALUE — извлекает скалярное значение;
- JSON_QUERY — извлекает объекты JSON и массивы JSON;
- JSON_TABLE — извлекает реляционные данные из данных JSON;
- JSON_MODIFY — изменяет существующие значения или добавляет новые.
Для обращения к элементам JSON применяется язык JSON Path.
Выражение пути (JSON-path) определяет, какие значения из исходных данных нужно обработать.
Например, чтобы из объекта JSON {"value": 135} получить значение 135, нужно обратиться к нему по пути $.value. Для второго элемента массива "tags":["json","путь","значение"] используется путь $.tags[1] (индекс массива начинается с 0).
Другой пример показывает, что нужно использовать значения, которые больше 4:
SELECT JSON_QUERY(
    '[{"value":4},{"value":6},{"value":42}]',
    'lax $.value ? (@>4)' WITH ARRAY WRAPPER)
FROM RDB$DATABASE;
Для обрабатываемых значений может быть указан формат.
- FORMAT JSON — формат, при котором указанное значение будет обрабатываться как JSON, даже если фактически значение является строкой.
- FORMAT SQL — формат, при котором указанное значение будет преобразовано в JSON скаляр, даже если фактически значение является JSON. Двойные кавычки и слеши будут экранированы.
- FORMAT AUTO — формат, при котором все значения, созданные функциями генерации данных (JSON_OBJECT, JSON_OBJECTAGG, JSON_ARRAY, JSON_ARRAYAGG) или являющиеся результатом работы функции JSON_QUERY, будут обрабатываться как JSON. Все остальные значения будут преобразованы в JSON скаляр.
Кроме этого, предикат RETURNING предназначен для указания типа данных выходного значения функции. Практически весь функционал был использован в этом примере.
Подробнее можно ознакомиться с поддержкой SQL/JSON в документации РЕД База данных Руководство по SQL
Параллельная загрузка JSON из приложения на GO
Данный пример демонстрирует создание простейшей программы на языке программирования Go (Golang) с использованием стандартного пакета database/sql для работы с базами данных. Мы рассмотрим, как подключиться к базе данных, разобрать JSON данные из файла и добавить их в таблицы БД.
Что рассмотрено в примере? В ходе разработки мы:
- Подключимся к базе данных.
- Прочитаем записи в формате JSON из внешнего файла.
- Выполним их синтаксический разбор.
- Пакетно загрузим их в несколько таблиц БД.
Какие инструменты и технологии используются?
- Язык программирования: Go (Golang).
- Пакет для работы с базой данных: database/sql и драйвер для РЕД База Данных — github.com/nakagami/firebirdsql.
- СУБД: РЕД База Данных 5.
- Операционная система: Windows или Linux (на примере РЕД ОС).
Установка GoLang
ОС Windows
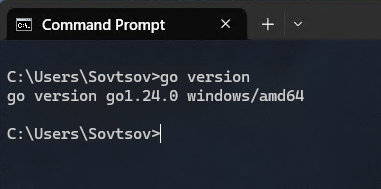
Linux
go --versionУстановка и настройка VS Code для работы на языке GoLang
sudo dnf install code- Запустить VS Code командой:
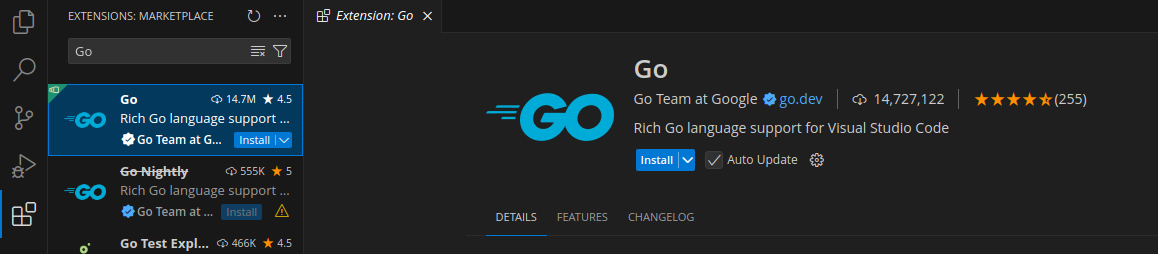
code- Перейдите во вкладку Extensions и в поиске введите Go и установите дополнение
Создание проекта
Linux
- Сначала нужно создать папку нашего проекта (он будет находиться в домашней директории)
mkdir ~/jsonloader- В папке проекта создадим файл main.go
- Инициализируем модуль Go
go mod init jsonloader- Откроем ее при помощи VS Code
code ~/jsonloader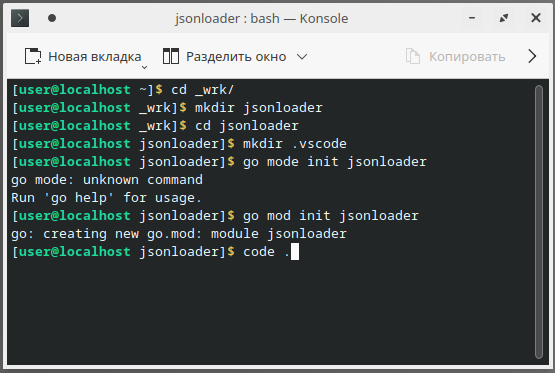
Windows
- Сначала нужно создать папку нашего проекта
- Откроем ее при помощи VS Code
- В папке проекта создадим файл main.go
- Инициализируем модуль Go
go mod init jsonloader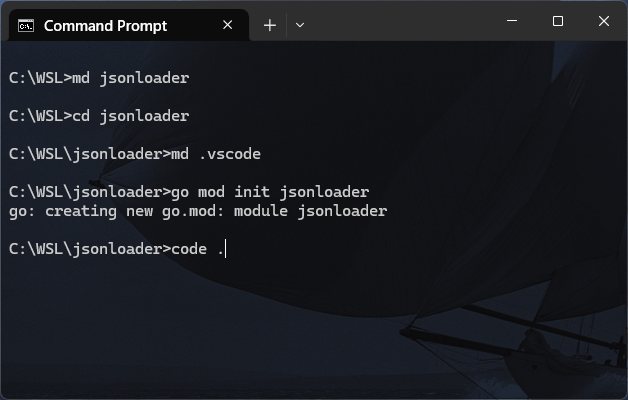
Далее
- Создадим новую папку в проекте и назовем ее .vscode (в ней будут храниться скрипты для сборки и запуска проекта для vscode)
- В папке .vscode создадим два файла launch.json и tasks.json
- В tasks.json запишем скрипт
   {
        "version": "2.0.0",
        "tasks": [
            {
                "label": "Build Go Project",
                "type": "shell",
                "command": "go",
                "args": ["build", "-o", "${workspaceFolder}/bin/"],
                "group": {
                    "kind": "build",
                    "isDefault": false
                },
                "problemMatcher": [],
                "detail": "Compile the Go project into a binary."
            },
            {
                "label": "Clean Build",
                "type": "shell",
                "command": "rm",
                "args": ["-rf", "${workspaceFolder}/bin"],
                "group": "build",
                "problemMatcher": [],
                "detail": "Clean up the bin directory."
            }
        ]
   }
Он будет выполнять 2 функции, собирать проект в папку bin и удалять собранные файлы.
- launch.json
{
    "version": "0.2.0",
    "configurations": [
        {
        "name": "Launch Project",
        "type": "go",
        "request": "launch",
        "mode": "debug",
        "program": "${workspaceFolder}",
        "env": {},
        "args": [
            "-u", "sysdba",
            "-p", "masterkey",
            "-H", "localhost:3050",
            "-dbpath", "NewDB.FDB",
            "-T", "SALES_REC (jsrc)",
            "-wks", "4",
            "/home/user/Tutorial/main/rdbtutorials/.main/input.json"
          ]
        }
    ]
}
Этот скрипт нужен для удобного запуска проекта.
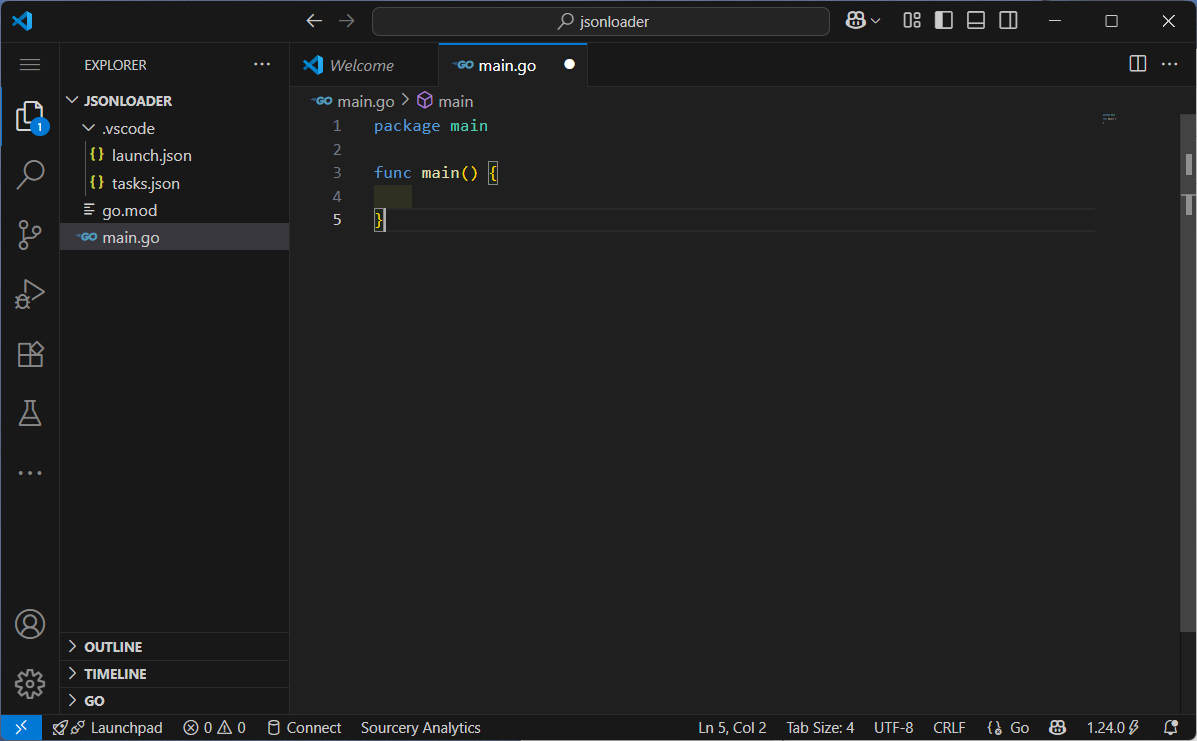
Подключите библиотеку в main.go (теперь import должен выглядеть так)
   import (
    "database/sql"
    "fmt"
    "log"

    _ "github.com/nakagami/firebirdsql"
   )
Загрузите нужную библиотеку
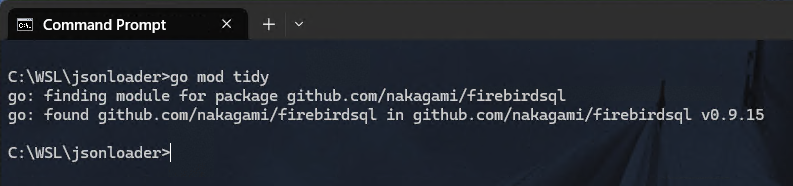
Теперь мы готовы к разработке функционала загрузчика.
Что должен уметь делать загрузчик?
Подавляющее большинство данных из внешней системы приходит в виде отчетов из системы на основе MongoDB в формате JSON — “родного” представления данных в MongoDB.
Входная порция внешних данных представляет собой файл, содержащий JSON-массив из большого количества JSON-объектов сложной структуры. Каждый объект соответствует одной записи о продаже.
Задача состоит в том, чтобы разобрать входной массив, и каждый объект из массива загрузить в виде поля отдельной записи в указанную таблицу демонстрационной БД SALES.
Полезно, если вызов загрузчика будет иметь следующий вид:
user@pc$ <loader> <параметры> <файл с загружаемыми данными>В качестве параметров нужны следующие данные:
- имя и пароль пользователя. Лучше всего, если пароль можно будет скрыть.
- имя/адрес хоста сервера СУБД
- порт для соединения с сервером
- путь к файлу БД на сервере
- имя таблицы БД и колонки, в которую будут загружены записи.
- при необходимости, другие
Реализация
Для работы с параметрами командной строки в Go стандартно используется пакет “flag”
import (
    "database/sql"
    "encoding/json"
    "flag"
    "fmt"
    "log"
    "os"
    "sync"
    "time"

    _ "github.com/nakagami/firebirdsql"
)

var SQLSTMT string = `INSERT INTO src_sales (JSRC) VALUES (?);`

func main() {

    // Declare flags with default values and help text
    user := flag.String("u", "sysdba", "пользователь")
    psw := flag.String("p", "mypsw", "пароль")
    verbose := flag.Bool("verbose", false, "разрешить подробности")
    dbpath := flag.String("dbpath", "c:/_data/_NewDB.FDB", "путь к файлу БД")
    hostport := flag.String("H", "localhost:3050", "Host & port для СУБД")
    dbtable := flag.String("T", "SALES_REC (jsrc)", "Таблица и колонка для загрузки")
    viaproc := flag.String("E", "", "Для теста процедуры")
    //, например: \"TABLE (fld_blob)\"
    wks := flag.Int("wks", 25, "Одновременных исполнителей")

    if len(os.Args) < 2 {
        fmt.Printf("Usage: %s <флаги> src_file\n", os.Args[0])
        flag.PrintDefaults()
        return
    }
    // Parse the command-line arguments
    flag.Parse()

    // Access the parsed values

    RDBconnStr := fmt.Sprintf("%s:%s@%s/%s", *user, *psw, *hostport, *dbpath)
    if *viaproc != "" {
        SQLSTMT = fmt.Sprintf("Call %s (?);", *viaproc)
    } else {
        SQLSTMT = fmt.Sprintf("INSERT INTO %s VALUES (?);", *dbtable)
    }
    verboseMod := *verbose
    if verboseMod {
        fmt.Println("Verbose mode is enabled.")
    }

    // Access any remaining positional arguments
    src_file := flag.Args()[0]
В этом фрагменте из main.go заданы имена флагов, их значения по умолчанию и краткие пояснения. В результате, при пропуске параметров или ошибке в них программа выдаст подсказку.
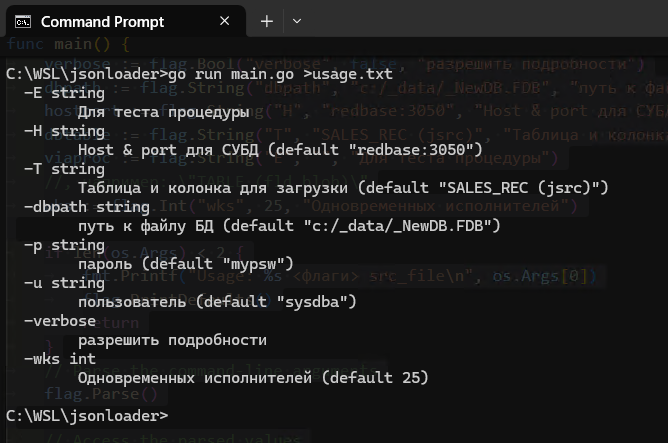
Средства встроенного пакета “encoding/json” позволяют выполнить разбор синтаксиса JSON-файла с данными и передать результаты разбора в переменные в памяти.
В данном случае задача несколько упрощается, так как окончательный разбор объектов JSON будет выполнять SQL/JSON на сервере СУБД РЕД База Данных.
Поэтому в программе разбирается только массив верхнего уровня, а объекты из него помещаются в слайс recs в формате “сырого” JSON.
  // Read json file
    file, err := os.Open(src_file)
    if err != nil {
        log.Fatalf("unable to read file: %v", err)
    }
    defer file.Close()
    log.Println("Данные получены из:", src_file)

    var recs []json.RawMessage // Declare a slice of your struct type

    // Decode JSON file
    decoder := json.NewDecoder(file)
    // fmt.Println("decoder created")

    err = decoder.Decode(&recs)
    if err != nil {
        log.Fatalf("Error decoding JSON: %v", err)
    }
    fmt.Printf("Раскодированы %d записи(ь)\n", len(recs))

    // Now 'recs' contains the data from your JSON array
Соединяемся с БД. При неудаче завершаем программу с кодом ошибки.
    // RDBconnStr собирается из параметров *user, *psw, *hostport, *dbpath
    db, err := sql.Open("firebirdsql", RDBconnStr)
    if err != nil {
        log.Fatal(err)
    }
    defer db.Close()

    // Теперь БД открыта и готова для работы
Функция, выполняющая непосредственную вставку в таблицу БД порции данных из множества записей:
func processBatch(db *sql.DB, data []json.RawMessage) error {
    var tx *sql.Tx
    var err error
    tx, err = db.Begin()
    if err != nil {
        // fmt.Println(fmt.Errorf("failed to begin transaction: %w", err))
        return fmt.Errorf("failed to begin transaction: %w", err)
    }
    // fmt.Println("Transaction started")
    for i, item := range data {
        // Perform your database operation using tx
        rec := string(item)
        _, err = tx.Exec(SQLSTMT, rec)
        if err != nil {
            // Rollback on error
            tx.Rollback()
            // fmt.Println("Rollback")
            return fmt.Errorf("ROLLBACK:failed to insert item (%d) %s: %w", i, rec[11:51], err)
        }
    }
    // Конец порции
    err = tx.Commit()
    if err != nil {
        return fmt.Errorf("failed to commit transaction: %v", err)
    }
    // log.Printf("Commited after %d\n", len(data))
    return nil
}
Функция получает на вход открытое соединение с БД и массив записей для вставки в БД. Возвращает ошибку или nil в случае успеха. В самом начале открывает новую транзакцию БД. Затем для каждой записи из массива выполняет SQLSTMT (который был сформирован из шаблона и значения флага -T ) При неудаче выполняется откат (Rollback) всей транзакции. После успешной загрузки последней записи из переданного массива выполняется фиксация (Commit) открытой транзакции. Работа с транзакциями, Commit, Rollback реализована во встроенном пакете "database/sql".
Транзакции - необходимый, но достаточно затратный по времени и ресурсам инструмент СУБД. Поэтому открытие и фиксация транзакции не после каждой записи, а после целого пакета (порции входных данных) ускоряет загрузку. Но есть способ сократить время еще больше.
Язык Go известен развитыми и эффективными средствами параллельного выполнения кода. Для этого служат горутины и каналы данных, использование которых дает нам возможность таким образом сконструировать программу, чтобы загрузка прошла за минимальный отрезок времени. Применим паттерн параллельного выполнения “Set of Workers” (“группа рабочих”).
// "Рабочий"

type Task struct {
    jobnum int               //номер порции
    jdata  []json.RawMessage //порция данных
    lowB   int               //не используется
    highB  int
}

func worker(in chan Task, workerId int, db *sql.DB, wg *sync.WaitGroup) {
    for received := range in {
        err := processBatch(db, received.jdata)
        if err != nil {
            log.Fatalf("wkr: %d, goroutine Error: %v", workerId, err)
        }
    }
    // Когда канал закрыт происходит выход из цикла for
    // log.Printf("worker %d закончил", workerId)
    wg.Done()
}
Структура Task (“задание“) является единицей передачи данных по входному каналу “рабочему” (функции “worker“). Также ему передается его workerId (для диагностики), соединение с БД, через которое он должен выполнять свою работу, и группу синхронизации.
Пока в канале есть для него задания, рабочий запускает функцию вставки записей с порцией данных из очередного задания.
За управление делением данных на порции, помещением в канал “заданий” и созданием “рабочих” отвечает главная процедура main.
Количество “рабочих” - параллельно работающих заданий - указывается в параметрах строки запуска. Все данные делятся на указанное количество порций и помещаются в канал jobCh. “Рабочий” забирает задание из канала и обрабатывает его.
// Создание заданий
    numberOfWorkers := *wks //из командной строки
    w8 := sync.WaitGroup{}
    w8.Add(numberOfWorkers)

    jobCh := make(chan Task, numberOfWorkers+1)

    // создание группы worker
    for k := range numberOfWorkers {
        go worker(jobCh, k, db, &w8)
    }

    // выдача заданий
    inLen := len(recs)

    batchLast := -1
    batchSize := inLen / numberOfWorkers

    if batchSize > 0 {
        batchLast = inLen % batchSize
    } else {
        batchLast = inLen
    }
    fmt.Printf("Объем=%d jobs=%d порция=%d остаток=%d\n", inLen, numberOfWorkers,
        batchSize, batchLast)

    for lowb, job := inLen, 0; lowb > 0; lowb, job = lowb-batchSize, job+1 {
        lb := max(lowb-batchSize, 0)
        jobCh <- Task{
            jobnum: job,
            jdata:  recs[lb:lowb],
            lowB:   lb,
            highB:  lowb,
        }
    }

    // сообщаем, что новых заданий в канал не поступит
    close(jobCh)
    // ждем завершения всех заданий
    w8.Wait()
Весь проект с исходными текстами можно взять из прилагаемого архива
Для компиляции в исполняемый модуль выполните команду в окне терминала
go build -o "./bin/" -trimpathили непосредственно из VSCode:
нажать Ctrl-Shift-B
Из выпадающего списка выбрать пункт Build Go Project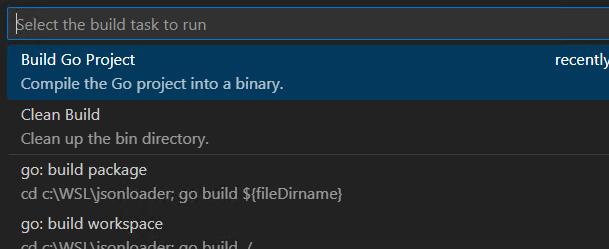
Первичные результаты
Скорость работы программы может зависеть от множества факторов. На разном оборудовании результат может сильно отличаться. Сравнительные замеры выполнялись в рамках единого имеющегося тестового стенда, который состоит из клиентского ноутбука, где компилировалась программа и хранились внешние данные, и виртуальной машины с Windows 10 - сервера СУБД с РЕД База Данных 5.0.
- Без использования средств параллельной обработки Go среднее время загрузки 5000 записей превысило 40 секунд.
- В параллельном режиме среднее время загрузки файла с 5000 записей оказалось около 4.5 секунд. Наименьшее время достигается при “группе рабочих” размером 25-33.
На другом оборудовании результат может отличаться как в одну, так и в другую сторону.
Разбор входных данных и загрузка в связанные таблицы
Итак, вся порция новых данных загружена на сервер БД в таблицу SALES, которая содержит колонку ID — первичный ключ с автоинкрементом и два длинных текстовых поля JVAR и JSRC. В них загружены одинаковые входные записи в разных типах представления — varchar и BLOB SUB_TYPE TEXT. Это было сделано для демонстрации возможности применения varchar, если хватает имеющихся ограничений на размер.
Таблица — временная: после разбора содержащихся в ней данных и занесения в основные таблицы аналитической БД ее можно (а перед загрузкой новой порции данных — необходимо) полностью очистить.
Разбор и загрузка JSON c хранимыми процедурами
Какую стратегию разбора и обработки данных стоит выбрать?
SQL оперирует наборами данных - множествами записей. Операции выборки в большинстве случаев возвращают множество записей в ответ на запрос. Основные операции объединения и пересечения выборок на основе разных критериев - предназначены для работы с множествами записей. Это одно из основных достоинств SQL, большинство реляционных СУБД прекрасно справляются с этими операциями и задачами. В то же время операторы PSQL для обхода каждой записи выборки могут работать значительно медленнее.
Однако на очень больших объемах данных и размерах выборок для операций над наборами данных приходится использовать индексы, партиционирование и другие хитрые приемы, чтобы добиться минимальных времен отклика. Возможности применения этих приемов могут быть ограниченными, чтобы обеспечить хорошее быстродействие системы в целом, а не только конкретного запроса.
В этом примере рассматриваются оба варианта.
Работа с множествами
Если выбрать множественный подход, то последовательность действий обработки всего входного массива будет примерно такой:
сделать запрос по всей таблице SALES, разобрать формат JSON, чтобы выделить ту часть информации из каждой записи, которая относится к покупателю (“customer”: {…}).
отобрать всех уникальных покупателей.
обновить таблицу CUST записями из этой выборки, которые пока отсутствуют в CUST.
сделать другой запрос по всей таблице SALES, разобрать формат JSON, выделить часть информации о продаже.
сделать JOIN с таблицей CUST для получения ссылки на запись о покупателе.
добавить все записи из выборки в таблицу SALE_RECORDS.
сделать другой запрос по всей таблице SALES, разобрать формат JSON, выделить данные из массива о продуктах, вошедшие в данную продажу ( {“items”:[ {“name”:”paper”, …} ] }) плюс внешний идентификатор продажи OID
сделать JOIN по OID с таблицей SALE_RECORDS, чтобы получить ссылку на актуальную запись о продаже
добавить все записи из выборки в таблицу ITEMS
В примере в таблице SALES содержится 5000 входных записей. Предположим, что среди них только 1000 новых покупателей. Присутствие покупателя должно проверяться по совпадению всех 3 полей: EMAIL, AGE, GENDER. Даже при наличии уникального индекса по этим полям, такая проверка идет для такого массива довольно медленно.
Аналогично со списком проданных товаров. С учетом того, что в каждой входящей записи описана продажа нескольких товаров, число входных записей для добавления в ITEMS увеличилось до 27500, так что пересечение для получения ссылки на актуальную добавленную запись о продаже может занять длительное время, даже при наличии индекса.
Без сомнения, можно найти более быстрый вариант.
Разбор и обработка записей по одной
Рассмотрим вариант с разбором и обработкой записей по одной.
Общая последовательность обработки практически совпадает с описанной выше, за исключением отсутствия необходимости делать JOIN между большими выборками. Оператор INSERT после выполнения добавления записей возвращает ID только что добавленной записи, который можно использовать для ссылки в записях про товары. Это существенно проще и намного быстрее, однако такие операции нужно повторить много раз - по количеству записей во входной таблице.
Для обработки каждой входной записи создана хранимая процедура IMPORT_SALE_JSON.
CREATE OR ALTER PROCEDURE IMPORT_SALE_JSON (
    SALE_INFO VARCHAR(8191)
)
AS
DECLARE cust_id bigint;
DECLARE srec_id bigint;
DECLARE sale_oid varchar(100);
DECLARE sale_date varchar(140);
DECLARE purchasevia varchar(50);
DECLARE storelocation varchar(100);
DECLARE withcoupon boolean;
DECLARE email varchar(200);
DECLARE gender char(5);
DECLARE age int;
DECLARE satisfacted int;
DECLARE it_name varchar(100);
DECLARE it_tags varchar(200);
DECLARE quantity int;
DECLARE price decimal(12,2);
BEGIN
 -- Проверка на валидность JSON
 IF (:sale_info IS NULL) THEN
 BEGIN
 EXCEPTION EMPTY_INPUT;
 END

    for
    select first 1
        jt.sale_date,
        jt.purchasevia,
        jt.storelocation,
        jt.withcoupon,
        jt.oid,
        jt.email,
        jt.gender,
        jt.age,
        jt.satisfacted
    FROM
        JSON_TABLE(
        :sale_info,
        'lax $' COLUMNS (
            sale_date varchar(140) path '$.saleDate."$date"' null ON EMPTY ERROR ON ERROR,
            purchasevia varchar(50) path '$.purchaseMethod' null ON EMPTY ERROR ON ERROR,
            storelocation varchar(100) path '$.storeLocation' null ON EMPTY ERROR ON ERROR,
            withcoupon boolean path '$.couponUsed' null ON EMPTY ERROR ON ERROR,
            oid varchar(100) path '$."_id"."$oid"' ERROR ON EMPTY ERROR ON ERROR,
            NESTED PATH '$.customer[0]' COLUMNS (
                email varchar(200) path '$.email',
                gender char(5) path '$.gender',
                age int path '$.age',
                satisfacted int path '$.satisfaction'
            )
        )
    ) as jt
    into
        :sale_date,
        :purchasevia,
        :storelocation,
        :withcoupon,
        :sale_oid,
        :email,
        :gender,
        :age,
        :satisfacted
    DO
    BEGIN
        /*
           Обновление списка покуптелей CUST
        */
        select c.ID from cust c where
        (c.email=:email and c.gender=:gender and c.age=:age)
        into :cust_id ;

        IF (:cust_id is Null) THEN BEGIN
            insert into CUST (email, gender , age)
            values (:email, :gender , :age)
            returning id into :cust_id;
        END

    /* ССылка на запись покупателя теперь в :CUST_ID  */

    IF (EXISTS (
        select 1 from SALE_RECORDS where OID = :sale_oid
    ))
    THEN
    BEGIN
        select srec_id from SALE_RECORDS where OID = :sale_oid
        into :srec_id;
    END
     ELSE
     BEGIN
        INSERT into SALE_RECORDS (
        SALE_DATE, PURCHASEVIA, STORELOCATION, WITHCOUPON, CUST_REF, SATISFACTED, OID
        ) VALUES (
            cast( left( replace(:sale_date,'T',' '),char_length(:sale_date)-1) as timestamp),
            :purchasevia, :storelocation, :withcoupon, :cust_id, :satisfacted, :sale_oid
         )
         returning srec_id into :srec_id ;
     END
    END

    /* Ссылка на запись о продаже теперь в :SREC_ID  */

    IF (NOT (EXISTS (
        SELECT 1 FROM ITEMS IT WHERE it.SALE_REF = :srec_id
    )))
    THEN
    BEGIN
        FOR
        SELECT
            jt.it_name,
            jt.it_tags,
            jt.quant,
            jt.price
        FROM
        JSON_TABLE(
         :sale_info,
        'lax $' COLUMNS (
            NESTED PATH 'lax $.items[*]' AS SUBIt COLUMNS (
            it_name varchar(100) PATH '$.name',
            it_tags varchar(200) format json PATH '$.tags[*]' WITH ARRAY wrapper,
            quant int PATH '$.quantity' DEFAULT '-1' ON ERROR --DEFAULT '0' ON EMPTY
            , NESTED PATH '$.price' COLUMNS (
                price decimal(12, 2) PATH '$."$numberDecimal"' DEFAULT '-1' ON ERROR
              )
            )
          )
        ) AS jt
        INTO
            :it_name,
            :it_tags,
            :quantity,
            :price
        DO
        BEGIN
            INSERT into ITEMS (
            SALE_REF,
            IT_NAME, IT_TAGS, IT_QUANT, IT_PRICE
            ) VALUES (
            :SREC_ID,
            :it_name, :it_tags, :quantity, :price
            );
        END
    END
END;
Как это работает?
Процедура получает строку с JSON текстом через единственный входной параметр типа VARCHAR(8191). Это максимальная длина строки для кодировки UTF8. В данном примере этого хватает, но можно переопределить его как домен JSON.
CREATE DOMAIN JSON AS BLOB SUB_TYPE TEXT;
Если параметр не содержит строку (она пустая), возвращается прерывание.
Определяется набор внутренних переменных для хранения данных из разобранного JSON.
Далее следует разбор JSON из этой строки, добавление полученной при разборе информации в таблицы БД.
Для разбора применяется SQL/JSON.
Чтобы правильно разобрать JSON данные, необходимо заранее знать структуру входящей JSON-записи или объекта.
Здесь представлена структура каждого объекта из входного массива.
Во фрагменте ниже
        select first 1
            jt.sale_date,
            jt.purchasevia,
            jt.storelocation,
            jt.withcoupon,
            jt.oid,
            jt.email,
            jt.gender,
            jt.age,
            jt.satisfacted
        FROM
            JSON_TABLE(
              :sale_info,
              'lax $' COLUMNS (
                        sale_date varchar(140) path '$.saleDate."$date"' null ON EMPTY
                        ERROR ON ERROR,
                        purchasevia varchar(50) path '$.purchaseMethod' null ON EMPTY
                        ERROR ON ERROR,
                        storelocation varchar(100) path '$.storeLocation' null ON
                        EMPTY ERROR ON ERROR,
                        withcoupon boolean path '$.couponUsed' null ON EMPTY ERROR ON ERROR,
                        oid varchar(100) path '$."_id"."$oid"' ERROR ON EMPTY ERROR ON ERROR,
                        NESTED PATH '$.customer[0]' COLUMNS (
                            email varchar(200) path '$.email',
                            gender char(5) path '$.gender',
                            age int path '$.age',
                            satisfacted int path '$.satisfaction'
                        )
                    )
            ) as jt
        into
            :sale_date,
            :purchasevia,
            :storelocation,
            :withcoupon,
            :sale_oid,
            :email,
            :gender,
            :age,
            :satisfacted
SELECT разбирает входную строку из параметра процедуры sale_info в соответствии с указанной выше структурой. Выделяются все данные, кроме перечня товаров, проданных в рамках данной продажи, в том числе из вложенного объекта “customer”. Полученные данные помещаются в соответствующие переменные.
Конструкция SQL
FOR SELECT
...
DO BEGIN
...
END
позволяет выполнить целый блок действий для каждой записи из результирующего набора
В данном случае:
        /*
           Обновление списка покупателей CUST
           - ищется покупатель с такими же значениями полей.
           - Если он найден, сохраняется его cust_id в переменной с тем же именем
           - Если такого не нашлось - добавляется новая запись и в переменной сохраняется
           уже ее идентификатор
        */
          select c.ID from cust c where
            (c.email=:email and c.gender=:gender and c.age=:age)
          into :cust_id ;

          IF (:cust_id is Null) THEN BEGIN
            insert into CUST (email, gender , age)
                values (:email, :gender , :age)
                        returning id into :cust_id;
          END

          /* Ссылка на запись покупателя теперь в :CUST_ID  */
Далее проверяется наличие в БД текущей записи о продаже (по уникальному идентификатору из БД MongoDB - типа OID) [1]
Если такая есть, то сохраняется ее идентификатор srec_id, если такая отсутствует - добавляется новая запись с полученными значениями, и сохраняется уже ее идентификатор для ссылки.
Здесь пришлось выполнить некоторые операции со значением поля SALE_DATE для перевода ее из символьного формата в стандарте ISO в тип данных TIMESTAMP СУБД РЕД База Данных.
    IF (EXISTS (
        select 1 from SALE_RECORDS where OID = :sale_oid
    ))
    THEN
    BEGIN
        select srec_id from SALE_RECORDS where OID = :sale_oid
        into :srec_id;
    END
     ELSE
     BEGIN
        INSERT into SALE_RECORDS (
        SALE_DATE, PURCHASEVIA, STORELOCATION, WITHCOUPON, CUST_REF, SATISFACTED, OID
        ) VALUES (
            cast( left( replace(:sale_date,'T',' '),char_length(:sale_date)-1) as timestamp),
            :purchasevia, :storelocation, :withcoupon, :cust_id, :satisfacted, :sale_oid
         )
         returning srec_id into :srec_id ;
     END
    END

    /* Ссылка на запись о продаже теперь в :SREC_ID  */
Наконец, идет обработка массива строк о товарах, участвовавших в данной продаже.
Только в том случае, если в таблице ITEMS отсутствуют записи, относящиеся к данной продаже, с помощью SQL/JSON разбирается массив “items” из входной строки, и добавляются новые записи, ссылающиеся на актуальную запись о продаже.
IF (NOT (EXISTS (
        SELECT 1 FROM ITEMS IT WHERE it.SALE_REF = :srec_id
    )))
    THEN
    BEGIN
        FOR
        SELECT
            jt.it_name,
            jt.it_tags,
            jt.quant,
            jt.price
        FROM
        JSON_TABLE(
         :sale_info,
        'lax $' COLUMNS (
            NESTED PATH 'lax $.items[*]' AS SUBIt COLUMNS (
            it_name varchar(100) PATH '$.name',
            it_tags varchar(200) format json PATH '$.tags[*]' WITH ARRAY wrapper,
            quant int PATH '$.quantity' DEFAULT '-1' ON ERROR --DEFAULT '0' ON EMPTY
            , NESTED PATH '$.price' COLUMNS (
                price decimal(12, 2) PATH '$."$numberDecimal"' DEFAULT '-1' ON ERROR
              )
            )
          )
        ) AS jt
        INTO
            :it_name,
            :it_tags,
            :quantity,
            :price
        DO
        BEGIN
            INSERT into ITEMS (
            SALE_REF,
            IT_NAME, IT_TAGS, IT_QUANT, IT_PRICE
            ) VALUES (
            :SREC_ID,
            :it_name, :it_tags, :quantity, :price
            );
        END
    END
Процедура загрузки готова.
Осталось продумать еще пару вопросов:
- Как обеспечить вызов процедуры для каждой записи из временной таблицы SALES?
- Как действовать если что-то пошло не так?
- Про автоматизацию загрузки
- Может не сработать в другом примере.↩︎
Загрузка с помощью View и триггера
Подумаем над решением для первого вопроса:
- Как обеспечить вызов процедуры для каждой записи из временной таблицы SALES?
Существует ли в РЕД Базе Данных способ загрузить в таблицу все записи из выборки (из другой таблицы, представления и т.п) одной командой SQL?
Как вариант, это можно было бы сделать так:
INSERT into TARGET(col1,col2, ...) SELECT FLD1, FDL2, ... FROM SALES; Средства SQL JSON (например, JSON TABLE) позволяют разобрать синтаксис JSON записей из таблицы SALES в рамках одного оператора SELECT. Но в нашем случае INSERT нужно делать не в одну, а сразу в 3 связанные таблицы, да так, чтобы гарантировано обеспечить целостность данных. С другой стороны, у нас есть процедура, которая делает то, что требуется, но INSERT в процедуру синтаксис стандартного SQL не предусматривает.
Все же, стандартный SQL предоставляет способ обойти эту проблему. Это триггеры!
Триггер является программой, которая хранится в области метаданных базы данных и выполняется на стороне сервера. Он вызывается автоматически при наступлении одного или нескольких событий, относящихся к одной конкретной таблице (к представлению), или при наступлении одного из событий базы данных.
- В триггере можно вызывать хранимую процедуру и передавать ей значения параметров на базе старых или новых значений полей записей этой таблицы или представления.
- Табличные триггеры выполняются в контексте той транзакции, в контексте которой выполнялся запрос или программа, вызвавшие соответствующее событие.
Следовательно, нужно создать специализированное представление и триггер на событие вставки в него, в котором вызвать процедуру разбора входной JSON-строки.
Создадим такое представление и назовем его INPUT_PARSER:
/* INPUT_PARSER */
CREATE OR ALTER VIEW INPUT_PARSER (INSTRING)
AS
    select first 1 coalesce(jvar,jsrc) instring from SALES
;
В этом представлении предусмотрено единственное поле INSTRING, в которое будем помещать входную запись.
В данном варианте представления внутренний select возвращает первое ненулевое значение из поля JVAR или JSRC из таблицы SALES.
Нам потребуется единственный триггер, который будет назначен на все события BEFORE INSERT OR UPDATE OR DELETE. Однако, запускать процедуру он будет только при наступлении события BEFORE INSERT, а на остальные — просто ничего не делать. В процедуру передается вставляемое значение из поля INSTRING, которое содержит данные об одной продаже в формате JSON.
/* INSERT_PARSER */
CREATE OR ALTER TRIGGER INSERT_PARSER FOR INPUT_PARSER
ACTIVE BEFORE INSERT OR UPDATE OR DELETE POSITION 0
AS BEGIN
    if (INSERTING) then
    begin
       execute procedure IMPORT_SALE_JSON(NEW.INSTRING);
    end
END;
Теперь, разбор и загрузка целиком всей очередной порции будет запускаться одним оператором SQL:
INSERT INTO INPUT_PARSER (INSTRING)
    SELECT CAST(JSRC AS VARCHAR(3000)) FROM SALES
Что получилось в результате:
-
Благодаря применению представления и триггера удалось избежать медленного цикла перебора для каждой входящей записи из таблицы SALES. Все содержимое таблицы SALES загружается сразу в три таблицы базы данных одним оператором INSERT
-
Загрузка может быть выполнена в рамках единой транзакции для каждой записи или всего пакета целиком.
-
Процедура написана таким образом, что исключает повторную загрузку одних и тех же данных. Ее можно запускать несколько раз. В случае сбоя можно повторить, чтобы добавить оставшиеся записи.
-
Наличие представления INPUT_PARSER позволяет внешнему приложению-загрузчику загружать данные не в промежуточную таблицу SALES, а прямо в представление. Таблицу SALES можно удалить.
-
Загрузку можно производить не только из таблицы SALES или приложения-загрузчика, но и, например, из файлового блоба с помощью запроса типа
INSERT INTO INPUT_PARSER (INSTRING) SELECT JSON_TABLE ... READ_FILE('BLOB_DIR/JSRC2.TXT') FROM RDB$DATABASE -
Предложенное решение хорошо автоматизируется.
-
Найден вариант ответов для решения задач из остальных вопросов из предыдущей главы.
Журналирование действий с данными
К этому моменту была разработана система пополнения демонстрационной БД SALES данными, пришедшими из внешних источников в формате JSON. Однако, для финансовых систем характерно обязательное наличие средств учета и контроля полученных записей. Например, для записей о продажах желательно иметь учет того, какие записи были добавлены и какие записи были изменены (что именно и когда). Стандартным решением является ведение журнала действий с записями.
В данном случае простейшей БД требуется журнал действий с 2 таблицами:
- SALE_RECORDS – факт продажи
- ITEMS – сумма продажи и количество товаров
БД нормализована, следовательно, эти таблицы имеют разную структуру и хранят разную информацию. Важные для учета общие части информации – это:
- дата-время изменения
- номер транзакции
Остальные поля - отличаются, но можно собрать всю информацию в строку в формате JSON и поместить в одно поле единственной таблицы. Для удобства фильтрации можно добавить поле с названием учитываемой таблицы.
Таким образом, для задачи учета и ведения журнала изменений требуется добавить еще одну таблицу
CREATE TABLE SALES_LOG (
 ID BIGINT GENERATED ALWAYS AS IDENTITY (START WITH 1),
 TRANS_ID BIGINT NOT NULL,
 TRANS_TIME TIMESTAMP NOT NULL,
 TABLE_NAME VARCHAR(255) CHARACTER SET UTF8 NOT NULL,
 DATA VARCHAR(255));
с полями:
| имя | хранимые данные |
|---|---|
| ID | первичный ключ |
| TRANS_ID | номер транзакции |
| TRANS_TIME | точное время события |
| TABLE_NAME | имя таблицы для учета |
| DATA | нужные данные в формате JSON |
Какие именно данные нужны для журнала?
- Кто и когда сделал изменения. Номер транзакции и время позволяют получить полную информацию для ответа на этот вопрос
- Для таблицы SALE_RECORDS (факт продажи) полезно сохранить для учета ссылку на запись о покупателе, ID записи SREC_ID, дату продажи и ID внешней записи, чтобы понимать, какие записи из входного потока не попали в БД.
- Кроме того, желательно сохранить начальные данные о количестве видов товара, количестве каждого и общей сумме данной записи о продаже. Эти данные попадают в таблицу ITEMS и их требуется вычислять путем агрегации.
- При изменении записи желательно сохранить информацию о действии и значении полей после него.
- Фиксируется факт удаления записи и значения полей в этот момент.
Для демонстрации концепции решения и его быстрой реализации были рассмотрены два варианта.
В предыдущей главе уже применялись триггеры, которые вызываются автоматически при наступлении одного или нескольких событий, относящихся к одной конкретной таблице (к представлению), или при наступлении одного из событий базы данных.
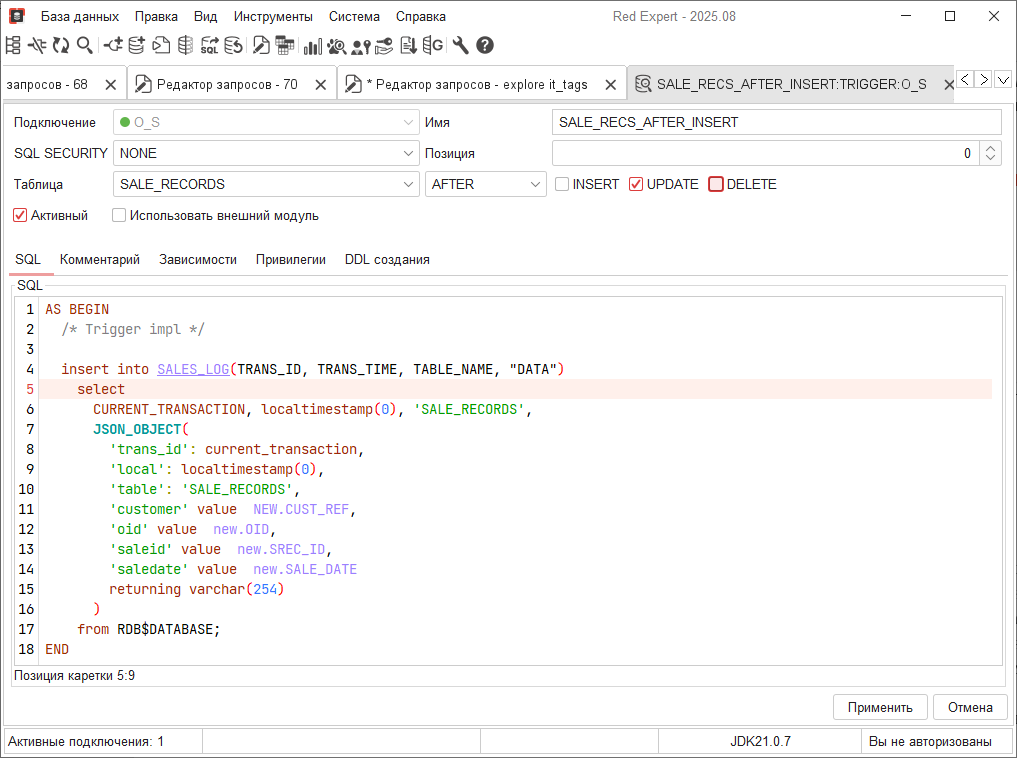
Можно воспользоваться триггером на вставку, изменение или удаление записи из таблицы SALE_RECORDS, чтобы сформировать JSON-строку с нужной информацией и вставить запись в таблицу SALES_LOG. Этот способ хорошо сработает при учете модификации или удаления записей SALE_RECORDS. Однако, на момент вставки новой записи в эту таблицу еще будут отсутствовать связанные записи в таблице ITEMS. Из-за этого для учета новых записей был применен второй способ.
Вставка новых записей в таблицу SALE_RECORDS происходит в результате импорта из данных в формате JSON. Разбор JSON и выделение информации из него происходит в процедуре IMPORT_SALE_JSON. В процессе разбора JSON-строки процедуре доступны записи из массива ITEMS для каждой записи о продаже. Разумным решением было бы включение кода для сохранения информации в журнал прямо в текст этой процедуры.
Были сделаны следующие дополнения в код процедуры:
- в строках 20..22 определены новые переменные
20 DECLARE it_cnt int; 21 DECLARE it_sum decimal(16,2); 22 DECLARE LMODE varchar(20); - которые были проинициализированы в строках 90, 96, 111, 112
90   LMODE = 'APPEND';
...
96   LMODE = 'INSERT';
...
111 it_cnt = 0;
112 it_sum = 0;
3. в строках 143, 144 выполняется подсчет сумм и агрегация данных из массива `items` в эти переменные
```sql
 :it_cnt = :it_cnt + 1;
:it_sum = :it_sum + (:quantity * :price);- Наконец, начиная с 155 строки выполняется сохранение всей необходимой информации в таблицу SALES_LOG в формате JSON. Для этого применяется оператор JSON_OBJECT из стандарта SQL/JSON РЕД База Данных.
IF (:it_cnt > 0) THEN
BEGIN
insert into SALES_LOG(TRANS_ID, TRANS_TIME, TABLE_NAME, "DATA")
 select
 CURRENT_TRANSACTION, localtimestamp(0), 'SALE_RECORDS',
 JSON_OBJECT(
 'trans_id': current_transaction,
 'local': localtimestamp(0),
 'table': 'SALE_RECORDS',
 'mode' value :LMODE,
 'customer' value :cust_id,
 'oid' value :sale_oid,
 'saleid' value :srec_id,
 'saledate' value cast( left( replace(:sale_date,'T',' '),char_length(:sale_date)-1) as timestamp),
 'items' value :it_cnt,
 'sum' value :it_sum
 returning varchar(254)
 )
 from RDB$DATABASE;
END
В результате в таблицу SALES_LOG попадают записи вида
select first 5 * from SALES_LOG;
Для учета других событий служит триггер.
Примеры отчетов по загрузке
/* число загрузок = транзакций */
select count(distinct trans_ID) from sales_log;
/*
count = 2
*/
/* число записей в каждой загрузке */
select trans_ID, count(*) from sales_log group by trans_id;
/*
TRANS_ID COUNT
-------- -----
10349 5000
10357 1
*/Итоги
В данном решении задачи учета и контроля данных демонстрационной БД SALES было показано, насколько полезны другие функции стандартного SQL/JSON СУБД РЕД База данных, в частности, функции генерации. JSON давно стал одним из основных форматов обмена данными, и функции генерации SQL/JSON значительно облегчают решение подобных задач.
Для упрощения описания этого примера не был реализован триггер на события в таблице ITEMS, но идея решения задачи ведения журнала изменений должна быть понятна и без этого.
Безусловно, в реальных системах ведению журналов уделяется намного больше внимания. Достаточно часто создается целый каскад триггеров и процедур, чтобы не пропустить ни единой возможности потерять какое-либо событие с данными.# Примеры запросов по БД SALES
Финансовые отчеты
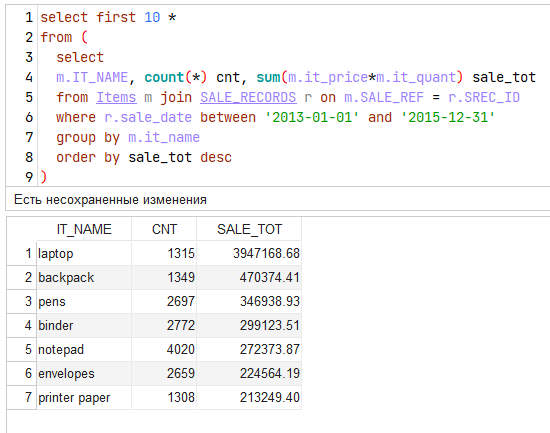
Требуется сводка за различные периоды времени. Например, для получения количества и сумм продаж электроники по годам за период с 1 января 2013 по 31 декабря 2015, можно выполнить такой запрос:
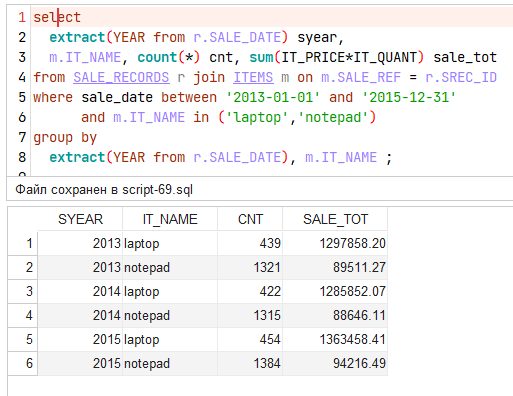
Чтобы получить значения, пригодные для группировки по различным календарным периодам, пришлось воспользоваться встроенной в РЕД Базу Данных функцией работы с датами EXTRACT. Если в запросе потребуется группировка по более мелким периодам, может оказаться выгоднее и удобнее (чтобы не повторять вызов функции в каждом запросе) создать специальное представление с полным набором полей с периодами группировки:
CREATE OR ALTER VIEW SALES_DATE_PARTS
  (SYEAR, SMONTH, SDAY, SHOUR, SWDAY, SYDAY, SQTR, SREC_ID, SALE_DATE, PURCHASEVIA,
   STORELOCATION, WITHCOUPON, CUST_REF, SATISFACTED, OID)
AS
  select
    extract(YEAR from r.SALE_DATE) syear,
    extract(MONTH from r.SALE_DATE) smonth,
    extract(DAY from r.SALE_DATE) sday,
    extract(HOUR from r.SALE_DATE) shour,
    extract(WEEKDAY from r.SALE_DATE) swday,
    extract(YEARDAY from r.SALE_DATE) syday,
    extract(QUARTER from r.SALE_DATE) sqtr,
    r.*
  from SALE_RECORDS r ;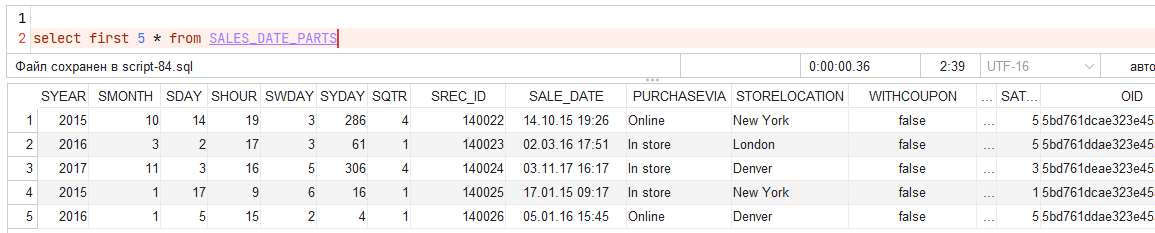
Список товаров и категорий
В демонстрационной БД названия товаров содержатся в строках каждого заказа в таблице ITEMS, а категории товара определяются списком тегов.
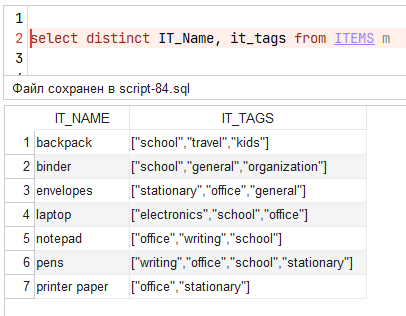
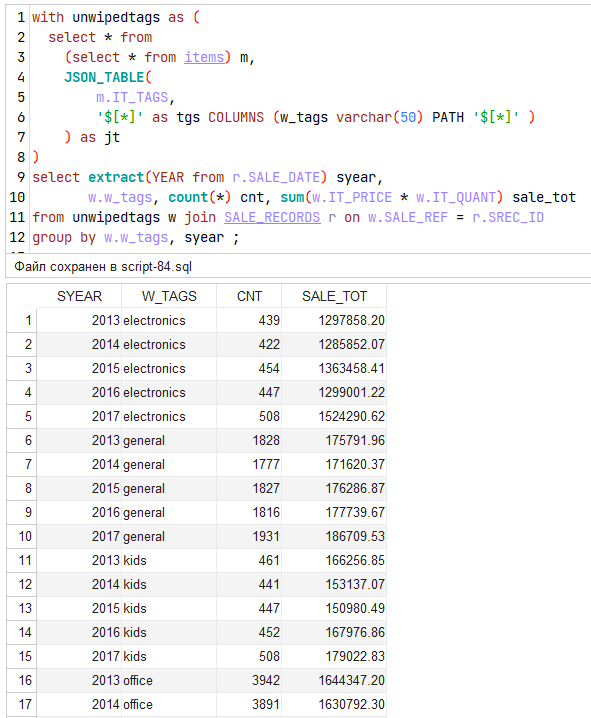
Обратите внимание, что теги-категории в каждой записи собраны в массив, что делает неудобным получение выборки данных по значениям отдельных тегов. Для таких выборок желательно “развернуть” каждую запись с массивом в несколько строк с единственным значением тега в каждой.
Развертывание по тегам
Наиболее удобным способом для этого оказалось применение уже знакомых операторов SQL/JSON.
--
-- развертывание массива IT_TAGS
--
select *
from
    (select * from items) m,
    JSON_TABLE(
        m.IT_TAGS,
        '$[*]' as tgs COLUMNS (w_tags varchar(50) PATH '$[*]' ) --OMIT QUOTES )
    ) as jt;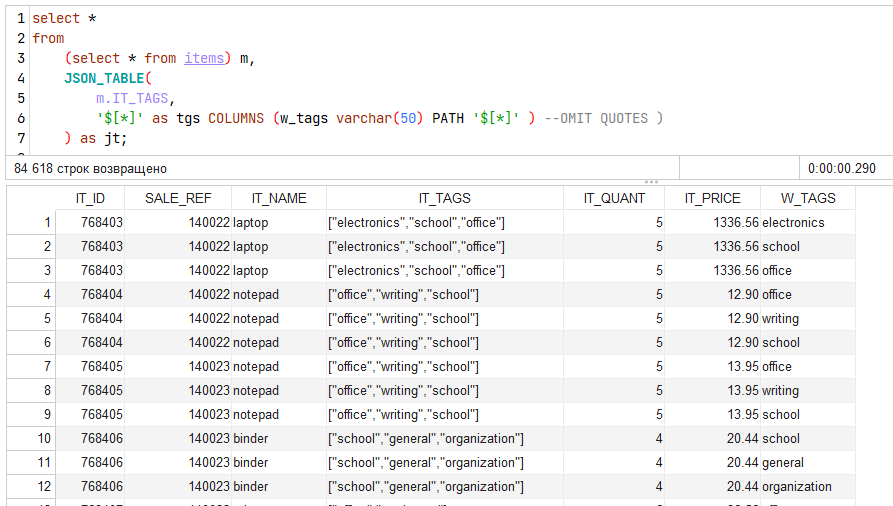
В демонстрационной БД SALES в таблице ITEMS находится почти 27500 записей, из которых после развертывания получается 84618. Это увеличение числа записей следует учитывать.
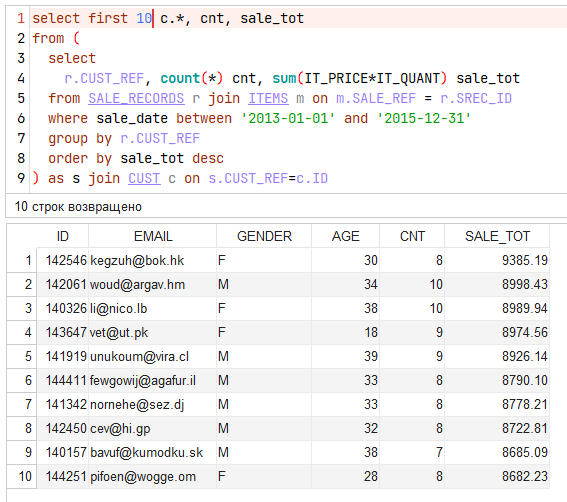
Топ 10 за период
Покупателей
Товаров
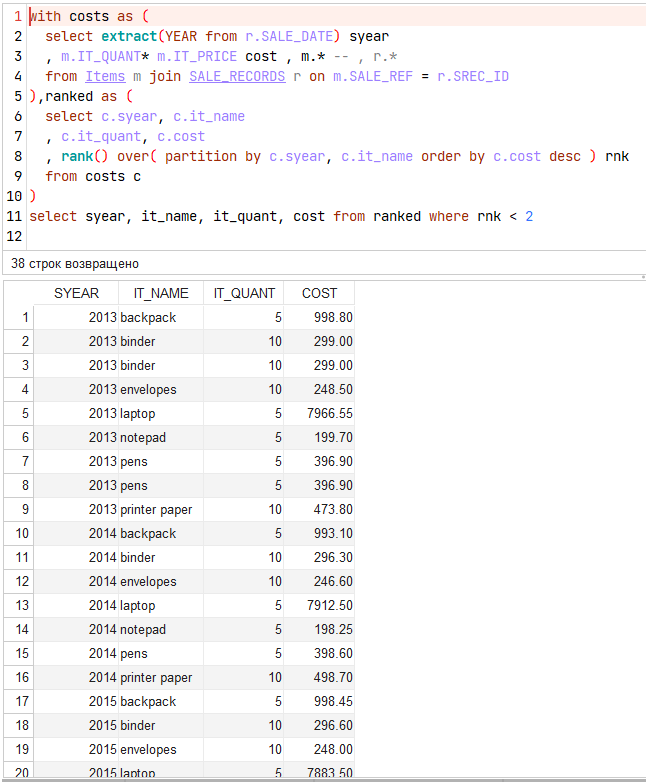
Лучшие продажи отдельных товаров по годам
Статистика за период
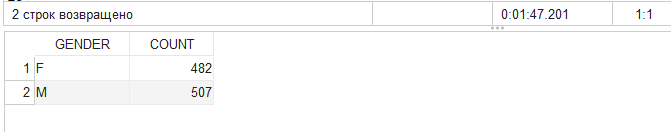
Число покупателей М/Ж рода за период
with salesfordates as (
    select * from    SALE_RECORDS where sale_date between ? and ?
),
dist_customers as (
    select distinct email, gender, age
    from    salesfordates r join cust c
    on cust_ref = c.id
)
select dc.gender, count(*)
from dist_customers dc
group by dc.gender;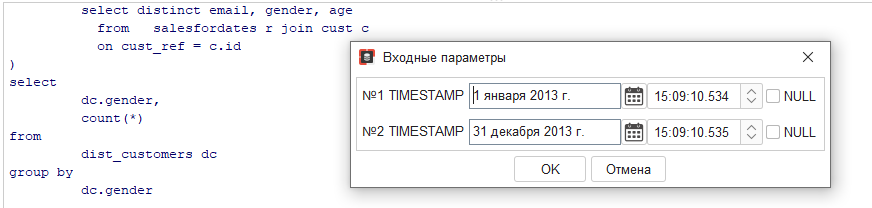
Статистика продаж складов
with stotals as (
 select sale_ref, sum(IT_PRICE*IT_QUANT) sale_tot
    from ITEMS
 group by sale_ref)
select
 r.STORELOCATION, count(*) sqty, sum(t.sale_tot) stotal
 from SALE_RECORDS r join stotals t on t.sale_ref = r.SREC_ID
 group by r.STORELOCATION
 order by stotal desc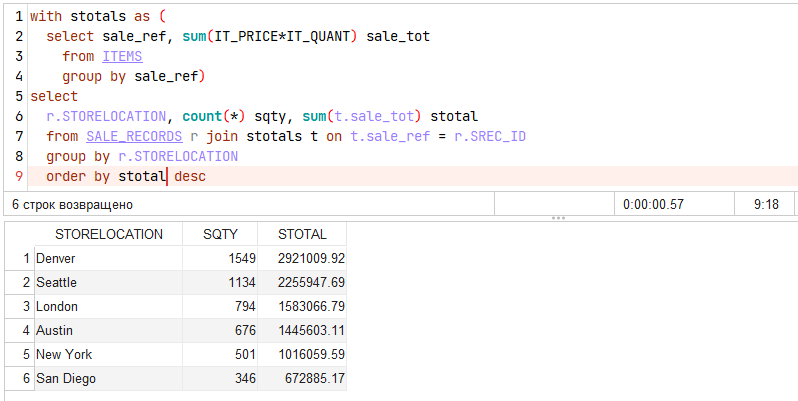
Динамика продаж складов по дням/ месяцам/годам
По годам.
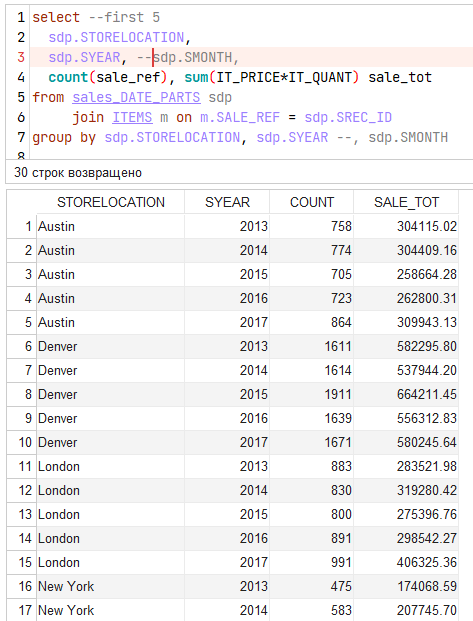
По месяцам
Если раскомментировать --sdp.SMONTH, получится значительно более длинный список, сгруппированный по каждому месяцу в году.
Продажи по сравнению с прошлым периодом
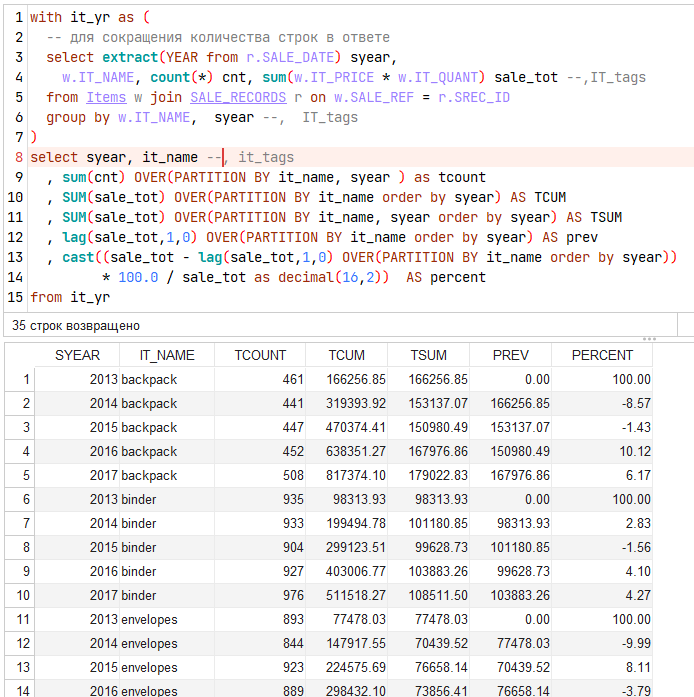
Продажи по годам в разрезе тегов
Дата последнего изменения: 07.11.2026
Если вы нашли ошибку, пожалуйста, выделите текст и нажмите Ctrl+Enter.