


 Скачать документ
Использование оконных функций SQL в СУБД РЕД База Данных
Учет измерений артериального давления.
Цель. Задача
Заболевания сердечно-сосудистой системы стоят на первом месте в списке причин смертности в мире. Многие люди вынуждены строго следовать назначенной терапии, принимать нужные препараты, чтобы болезнь не прогрессировала, а условия жизни оставались привычными. Таким людям необходим ежедневный контроль уровня кровяного давления. В наше время появилось много гаджетов, позволяющих измерять давление и сохранять результаты в персональных мобильных приложениях.
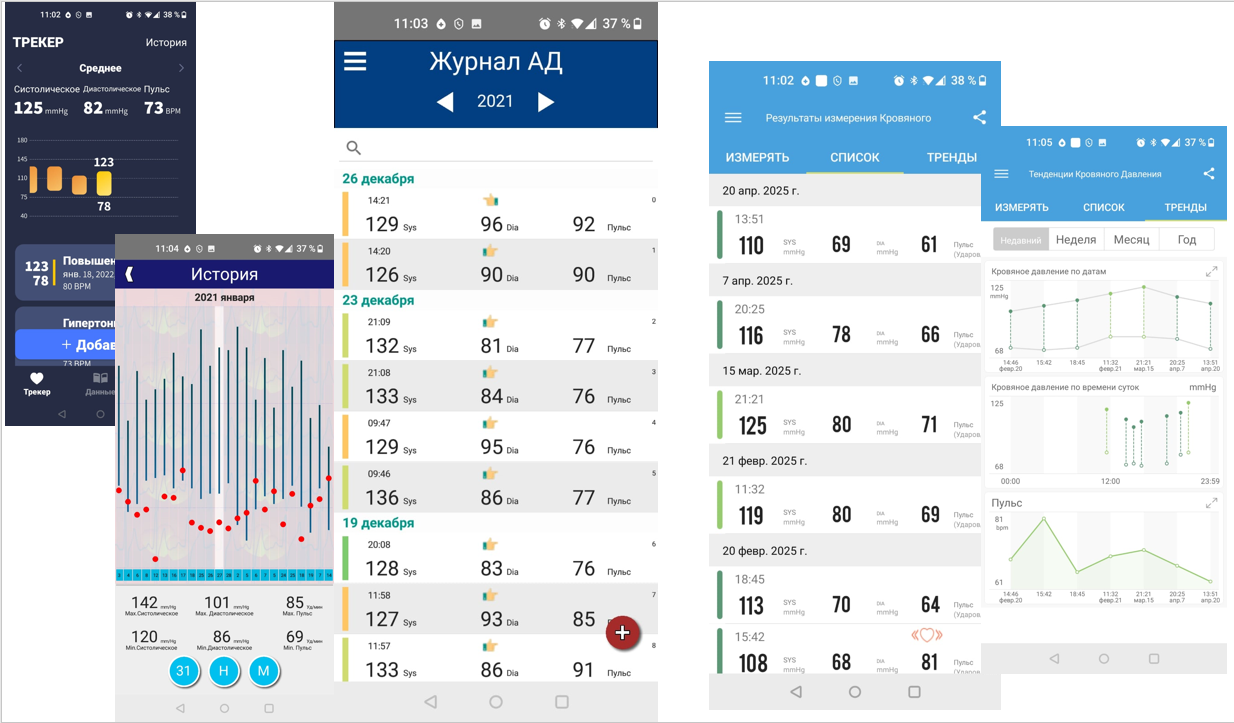 Примеры данных в различных мобильных приложениях
Собранные с множества устройств и объединенные данные могли бы быть подвергнуты статистической обработке и различным видам анализа. Это помогло бы врачам и фармацевтам в разработке более эффективных методов лечения и создании новых лечебных препаратов для таких пациентов. Базу собранных деперсонифицированных данных можно также использовать для обучения новых специализированных нейронных сетей ИИ для применения в лечебной практике.
Для подобных задач прекрасно подходит СУБД РЕД База Данных.
В этом примере будет показано, как можно применять ее широкие возможности для решения ряда вопросов из описанной задачи.
Исходные данные
Практически все мобильные программы персонального учета давления могут экспортировать накопленные данные в текстовые файлы, например, в формате JSON или CSV.
"PatientName";"ADDatetime";"ADHand";"ADSYS";"ADDIA";"PUL";"Active";"Notes";"ARythm"
" ";24.12.2021 17:15:40;"Левая";120;75;64;TRUE;"";TRUE
" ";24.12.2021 17:14:53;"Правая";120;75;64;TRUE;"";FALSE
"";23.12.2021 21:09:00;"";132;81;77;TRUE;"";
"";23.12.2021 21:08:00;"";133;84;76;TRUE;"";
"";23.12.2021 9:47:00;"";129;95;76;TRUE;"";
"";23.12.2021 9:46:00;"";136;86;77;TRUE;"";
"";19.12.2021 20:08:00;"";128;83;76;TRUE;"";
"";19.12.2021 11:58:00;"";127;93;85;TRUE;"";
"";19.12.2021 11:57:00;"";133;86;91;TRUE;"";
Для примера была использована база данных Medicine, но фактически пример оперирует двумя несвязанными таблицами: AD_TEMP и ADLOG4.
Поэтому для этого примера можно использовать любую собственную базу СУБД РЕД База Данных.
/* Создание вспомогательной таблицы для загрузки и трансформации данных */
CREATE TABLE AD_TEMP (
    PATIENTNAME VARCHAR(50),
    ADDATETIME TIMESTAMP,
    ADHAND CHAR(10),
    ADSYS INTEGER,
    ADDIA INTEGER,
    HB INTEGER,
    ISACTIVE BOOLEAN,
    ARYTHM BOOLEAN,
    NOTES VARCHAR(50),
    RID BIGINT
);
Загрузка в БД, создание PK. Проверка данных
При экспорте из разных приложений данные могут быть представлены в нескольких отличающихся форматах. Необходимо привести их к единому виду и провести конвертацию типов данных, если это необходимо. Для этого служат программы ETL. В этом примере достаточно инструмента импорта CSV-данных. Чтобы не усложнять пример, было применено приложение для работы с СУБД РЕД База Данных от компании РЕД СОФТ – РБД Эксперт.
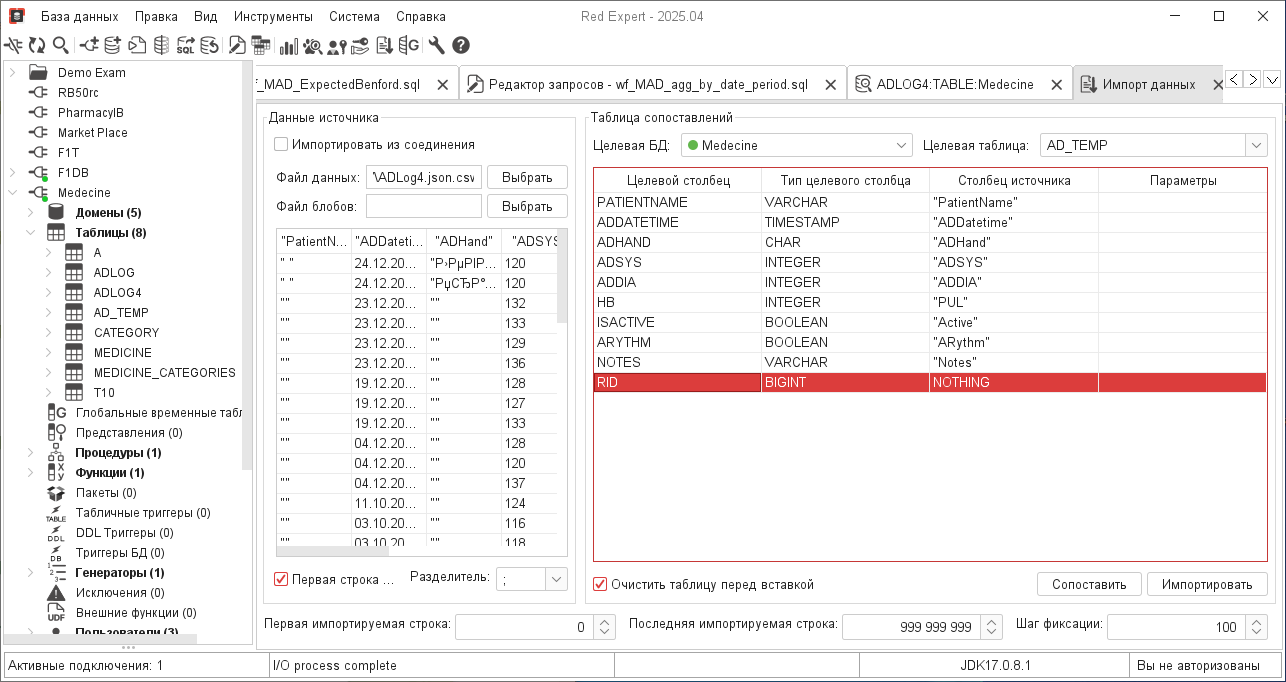 Пример использования инструмента РБД Эксперт для загрузки данных из CSV
CSV-данные были успешно загружены в таблицу AD_TEMP, однако у таблицы нет первичного ключа, даже составного. Наличие уникального идентифицирующего признака в реляционной теории является обязательным требованием нормализации данных. Требуется создать суррогатный уникальный ключ путем последовательной нумерации записей. В теории это можно сделать, например, с помощью оконной функции row_number():
 SELECT
   t.ADDATETIME,t.HB, t.RID, row_number() over() as RI
FROM AD_TEMP t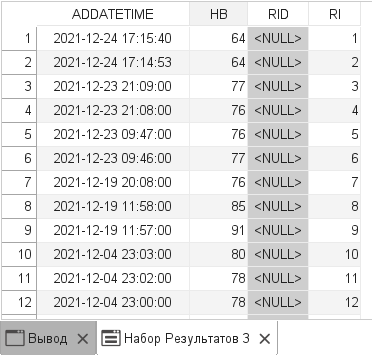 (и это было сделано с использованием довольно изощренного Update-запроса), но на практике гораздо проще воспользоваться автоинкрементным полем.
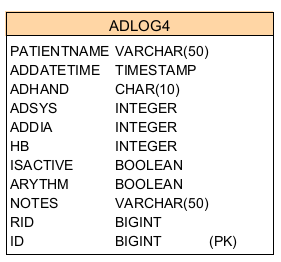
Создадим новую таблицу ADLOG4
CREATE TABLE ADLOG4 (
    PATIENTNAME VARCHAR(50),  -- имя пациента (в примере - пустое)
    ADDATETIME TIMESTAMP,     -- Дата, время измерения
    ADHAND CHAR(10),          -- Рука, на которой сделано измерение
    ADSYS INTEGER,            -- систолическое
    ADDIA INTEGER,            -- диастолическое
    HB INTEGER,               -- пульс
    ISACTIVE BOOLEAN,
    ARYTHM BOOLEAN,           -- наличие аритмии
    NOTES VARCHAR(50),        -- комментарий
    RID BIGINT,               -- поле для суррогатного ключа
    ID BIGINT GENERATED BY DEFAULT AS IDENTITY (START WITH 1),
    CONSTRAINT PK_ADLOG4_1 PRIMARY KEY (ID));
Здесь было добавлено автоинкрементное поле ID с соответствующими параметрами. Далее вся магия запускается запросом
INSERT INTO ADLOG4 (
    PATIENTNAME,
    ADDATETIME,ADHAND,ADSYS,ADDIA,HB,
    ISACTIVE,ARYTHM,NOTES,RID
) SELECT
    PATIENTNAME,
    ADDATETIME,ADHAND,ADSYS,ADDIA,HB,
    ISACTIVE,ARYTHM,NOTES,RID
 FROM AD_TEMP;

COMMIT;

DROP TABLE AD_TEMP;
Теперь новые данные можно загружать прямо в ADLOG4
Группировка по календарным периодам. Работа с датами.
Одной из задач является получение показателей, обобщенных по заданному периоду: дням, месяцам, годам и т. п. Это помогает увидеть наличие и направление динамики показателей и оценить эффективность лечения. Как правило, в таких отчетах требуется показать размах значений (минимальные и максимальные) и среднее за период. Для таких запросов применяются агрегатные функции SQL:
/* набор агрегатов по дням */
select
  cast(addatetime as date) adday,
  count(*) cnt,
  min(adsys) min_sys, max(adsys) max_sys, avg(adsys) avg_sys
 ,min(addia) min_dia, max(addia) max_dia, avg(addia) avg_dia
 ,min(HB) min_HB, max(HB) max_HB, avg(HB) avg_HB
from
  adlog4 a
group by 1 -- по adday
Результат выполнения (первые 10 записей)
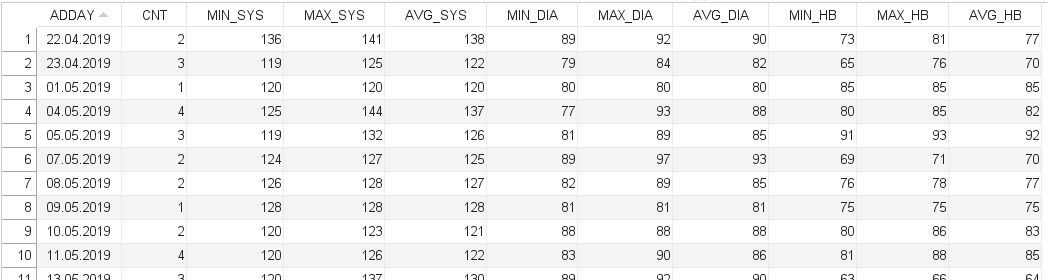
В запросе сначала функцией cast(addatetime as date) adday выделяется дата из значения дата+время, затем выполняется группировка по выделенной дате, в группах подсчитываются count+min+max+avg каждого из 3 показателей давления.
Немного сложнее для отчета по месяцам:
/* набор агрегатов по месяцам (в порядке следования дат) */
select
  extract(year from mnth) ||'/'|| extract(month from mnth) yyyymm,
  count(*) cnt,
  min(adsys) min_sys, max(adsys) max_sys, avg(adsys) avg_sys
 ,min(addia) min_dia, max(addia) max_dia, avg(addia) avg_dia
 ,min(HB) min_HB, max(HB) max_HB, avg(HB) avg_HB
from
  (select a.*, cast(extract(year from addatetime) ||'/'|| extract(month        from addatetime) || '/1' as date) mnth from adlog4 a) m
group by mnth
order by mnth
Хотелось бы, чтобы сгруппированные данные выдавались в порядке следования дат, а не лексической сортировки символов. Для этого в подзапросе в части from каждая дата измерения приводится к первому числу своего месяца,
cast(extract(year from addatetime) ||'/'|| extract(month from addatetime) || '/1' as date)а группировка и сортировка ведутся по этому преобразованному значению; перед выдачей первое число убирается, оставляя месяц в формате год/месяц
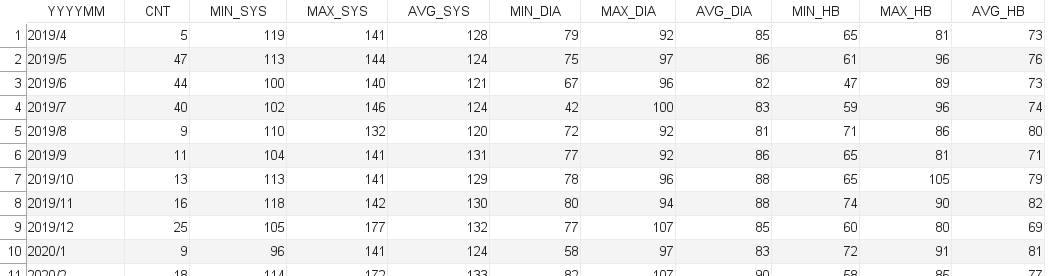
Группировка по году выполняется проще, но принцип тот же:
/* набор агрегатов по годам (в порядке следования дат) */
select
  cast(extract(year from addatetime) as integer) adyear,
  count(*) cnt,
  min(adsys) min_sys, max(adsys) max_sys, avg(adsys) avg_sys
 ,min(addia) min_dia, max(addia) max_dia, avg(addia) avg_dia
 ,min(HB) min_HB, max(HB) max_HB, avg(HB) avg_HB
from
  adlog4 a
group by 1
order by 1
Результат:

Здесь из даты измерения выделяется год как целое число, по которому затем группируются и сортируются данные.
Преобразование форматов дат, выделение периодов и вычисления с датами играют огромную роль в запросах для таких отчетов. Чтобы упростить их и ускорить выполнение, можно создать набор функций преобразования и использовать их в select
/*
  функция конверсии / форматирования
*/
create function iso8601timestamp(ts timestamp) returns varchar(20)
as
begin
 return extract(year from ts) ||
 '-' || lpad(extract(month from ts), 2, '0') ||
 '-' || lpad(extract(day from ts), 2, '0') ||
 'T' || lpad(extract(hour from ts), 2, '0') ||
 ':' || lpad(extract(minute from ts), 2, '0') ||
 ':' || lpad(extract(second from ts), 2, '0');
end
/* применение */
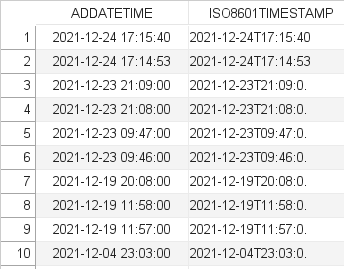
select addatetime, iso8601timestamp(addatetime) from adlog4
Пример функции преобразования даты+времени в формат ISI8601
или заранее дополнить данные полями с нужными периодами (как говорят, провести обогащение данных).
Интервал между наблюдениями
Чтобы результаты анализа данных были значимыми и надежными, необходимо иметь представление о качестве имеющихся данных. Проверка формальных условий качества и элементы разведочного анализа EDA дадут это представление. Для нашего примера таким условием является отсутствие пропущенных значений полей ADDATETIME и показателей ADSYS, ADDIA, HB. Также важно понимать, насколько регулярно пациент проводил измерения, не было ли длительных пропущенных интервалов времени, и насколько отличаются показатели в начале и конце таких пропусков.
/* Проверка наличия NULL в показателе SYSTOLIC */
select left(coalesce(addatetime,'0'),1) from adlog4 order by 1 desc
select left(coalesce(adsys,'0'),1) from adlog4 order by 1 desc
/* аналогично для addia, hb */
В запросах выдается самый первый символ от результата выполнения функции,
coalesce(addatetime,'0')
или
coalesce(adsys,'0')
которая проверяет значение указанного поля записи на NULL, а в положительном случае возвращает символ ‘0’. В примере таких нарушений не нашлось.
Для выборки измерения, следующего за каждым измерением, и вычисления длительности интервала между ними придется воспользоваться оконными функциями SQL. Выборка должна быть по каждому пациенту отдельно, но в примере код пациента отсутствует (примем, что он один)
/*
  Выборка показателей измерения и для следующего за ним
*/
select a4.ADDATETIME,a4.ADDIA, a4.ADSYS, a4.hb,
 lead(a4.ADDATETIME) over (order by a4.addatetime) as nxt_date,
 lead(a4.ADDIA) over (order by a4.addatetime) as nxt_dia,
 lead(a4.ADSYS) over (order by a4.addatetime) as nxt_sys,
 lead(a4.HB) over (order by a4.addatetime) as nxt_hb
from adlog4 a4
order by a4.ADDATETIME
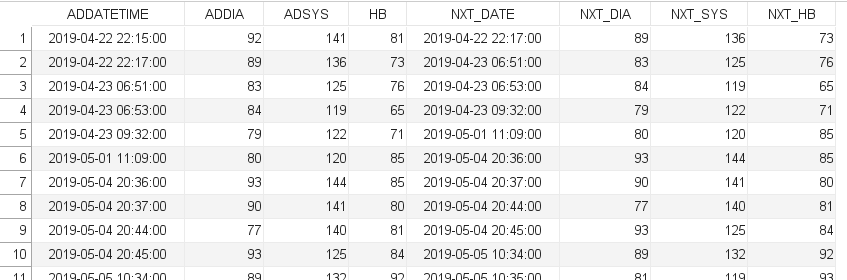 В запросе применялась одна из навигационных оконных функций SQL - lead.
Справка
LAG и LEAD LAG(<выражение> [, <смещение> [, ]]) OVER (...) LEAD(<выражение> [, <смещение> [, ]]) OVER (...)
Эти функции обеспечивают доступ к строке с заданным физическим смещением перед или после текущей строки (LAG и LEAD соответственно). По умолчанию смещение равно 1. (с) “Учебное пособие по языку SQL и PSQL”
Выражение over (order by a4.addatetime) ограничивает порядок окна просмотра до конца текущего значения addatetime.
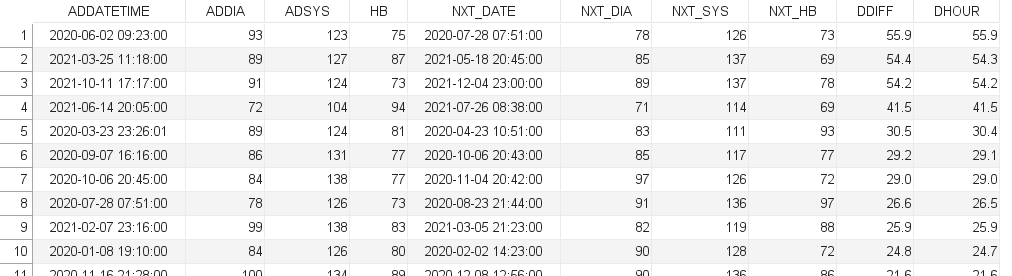
По полученным результатам видно, что запрос работает корректно, но длительность интервала придется вычислять вручную. Поручим это компьютеру:
select x.*,
  cast(x.nxt_date-x.addatetime as NUMERIC(3,1)) as ddiff,
  1.0*datediff(hour, x.addatetime, x.nxt_date) / 24 as dhour
from
(
  select a4.ADDATETIME,a4.ADDIA, a4.ADSYS, a4.hb,
    lead(a4.ADDATETIME) over (order by a4.addatetime) as nxt_date,
    lead(a4.ADDIA) over (order by a4.addatetime) as nxt_dia,
    lead(a4.ADSYS) over (order by a4.addatetime) as nxt_sys,
    lead(a4.HB) over (order by a4.addatetime) as nxt_hb
  from adlog4 a4
--order by a4.ADDATETIME
) x
order by ddiff desc
Внутренний подзапрос остался прежним, а внешний дополнительно вычисляет длительность интервала (в сутках). Поля ddiff и dhour демонстрируют различные способы вычисления и округления значения длительности. Теперь появилась возможность отсортировать результат, чтобы вверху оказались самые длинные пропуски (в примере — 55.9 дня)
Запрос можно упростить, если положиться на уникальный первичный ключ
/* тот же запрос через первичный ключ  */
select
    b.id,b.ADDATETIME,b.ADDIA, b.ADSYS, b.hb
    ,x.id,x.ADDATETIME,x.ADDIA, x.ADSYS, x.hb
    ,cast(b.addatetime-x.addatetime as numeric(3,1)) as ddiff
    ,1.0*datediff(hour, x.addatetime, b.addatetime) / 24 as dmday
from adlog4 b join
(
 select a.*
   ,lead(id) over (order by addatetime) as n_id
 from adlog4 a) x
on x.n_id = b.id
order by ddiff desc
Какой из запросов будет работать эффективнее следует проверять на практике.
В запросах выше предполагалось, что значения в поле, по которому скользит окно, сплошные - в нем отсутствуют значения NULL (в примере так оно и есть). А как быть, если “пустые” значения присутствуют? Или еще хуже — значения даты-времени могут повторяться? Сработает такой запрос с вложенным подзапросом:
select ADDATETIME,ADDIA, ADSYS, hb,
  lead(ADDATETIME,cnt-rn+1) over (order by addatetime) as nxt_date,
  lead(ADDIA,cnt-rn+1) over (order by addatetime) as nxt_dia,
  lead(ADSYS,cnt-rn+1) over (order by addatetime) as nxt_sys,
  lead(HB,cnt-rn+1) over (order by addatetime) as nxt_hb
from
    (
    select a4.ADDATETIME,a4.ADDIA, a4.ADSYS, a4.hb,
      count(*) over (partition by a4.addatetime) cnt,
      row_number() over(partition by a4.ADDATETIME order by a4.id) rn
    from adlog4 a4
    ) y
Подзапрос сгруппирует одинаковые значения addatetime и назначит им ранг, а в основном запросе вычисляемое на базе ранга смещение позволит правильно указать следующую группу записей.
Вычисление средних за календарный месяц и сопоставление с ними. Индикация групп
Иногда требуется получить агрегированные показатели для каждой исходной записи. Выше применялась оконная функция Lead() для добавления следующего значения, но можно использовать и остальные оконные функции для вычисления полей со сведенным по определенной группе показателем. В запросе ниже выводятся все поля исходной записи и среднее значение ADSYS за весь месяц измерений. В последнем поле результирующего набора стрелкой <- обозначается последняя запись текущего сводного месяца.
/*
вычисление средних за календарный месяц. индикация групп YYYYM
*/
select a.*, cast(addatetime as date) dt,
extract(year from addatetime)||extract(month from addatetime) em,
avg(adsys) over(partition by extract(year from addatetime)||extract(month from addatetime) ) ym_avgsys
, case when extract(month from addatetime) != lead(extract(month from addatetime)) over (order by addatetime)
then '<-' else ''
end grpend
from adlog4 a
order by dt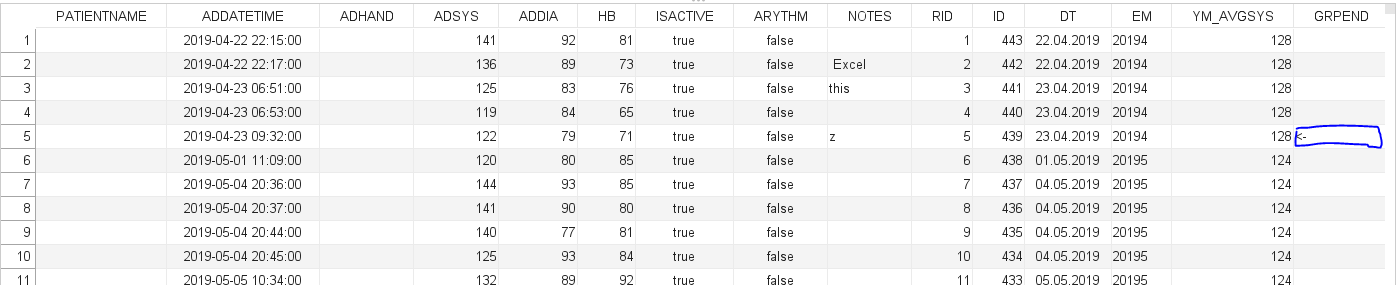 В запросе сначала выполняются преобразования дат в требуемый вид, затем в строке
avg(adsys) over(partition by extract(year from addatetime)||extract(month from addatetime) ) ym_avgsys при помощи агрегатной оконной функции avg() вычисляется среднее значение показателя ADSYS за весь текущий месяц. Это значение одинаково для всех записей, относящихся к данному месяцу. Оператор case сравнивает значение текущего месяца со следующим с помощью lead() и если они не совпадают, проставляет индикатор последней записи в группе в виде стрелки.
В таком запросе также можно получить результаты разного рода вычислений текущих значений и вычисленных агрегированных. Например, можно сразу же получить процентное отношение текущего значения ADSYS к среднемесячному:
/*
Использование именованных окон
*/
select a.*,
extract(year from addatetime)||extract(month from addatetime) em,
avg(adsys) over(w_year_month) ym_avgsys
, 100 * a.adsys / avg(adsys) over(w_year_month) rate --отношение текущего к среднему в %
, case when extract(month from addatetime) != lead(extract(month from addatetime)) over (w_addatetime)
then '<-'
else ''
end grpend
from adlog4 a
window
w_year_month as (partition by extract(year from addatetime)||extract(month from addatetime)),
w_addatetime as (order by addatetime)
order by addatetime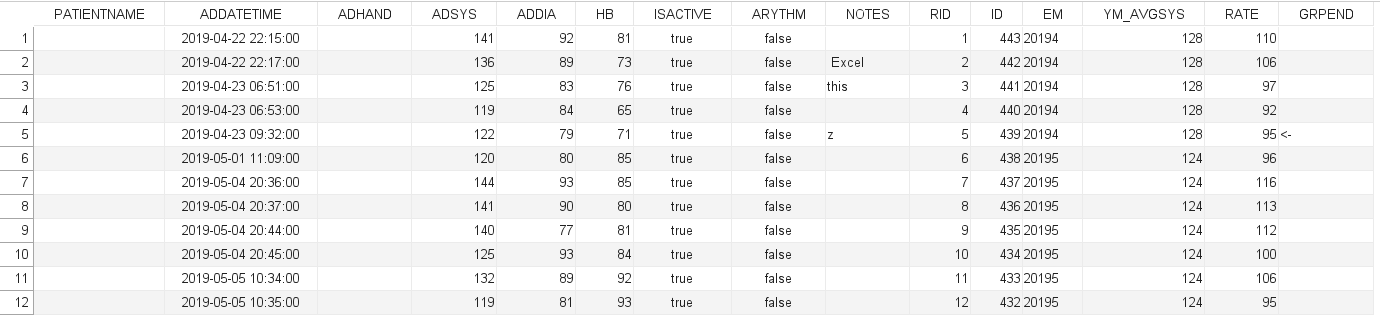 В этом запросе показано применение так называемых именованных окон, которые можно применять в оконных функциях по имени, не переписывая повторно условия каждый раз, когда оно применяется.
Итоги
Рассмотрен пример прикладной обработки элементарных медицинских данных в СУБД РЕД База Данных. Показана польза и гибкость применения оконных функций в стандартном SQL.
Краткая справка
Оконные функции — функции, которые выполняют вычисления внутри заданного набора данных или "окна" в таблице БД
Принцип работы
- Оконная функция (ОФ) определяет "окно" данных, на которых будет выполняться вычисление (несколько строк или диапазон значений столбца)
- Если требуется, данные внутри окна упорядочиваются по одному/нескольким столбцам.
- Применяются вычисления, заданные в ОФ (сумма, среднее значение, ранжирование и т. д.)
- Если требуется, результаты группируются по столбцам или выражениям
- Возврат результатов
Упрощенный синтаксис
<имя функции> OVER (<окно>)
где
- имя функции = имя оконной функции
- окно = выражение, описывающее набор строк для обработки и порядок обработки
Это не то же самое, что GROUP BY. Оконные функции не уменьшают количество строк, а возвращают столько же строк, сколько получили на вход. В отличие от агрегатных функций, оконные могут вычислять значения для каждой строки в результате запроса. Агрегатные функции работают над всем набором данных.
Виды
- агрегатные
- ранжирующие
- навигационные
Как используются?
- для определения порядка строк и их ранжирования в рамках группы данных. Например, можно выделить наиболее ранний или поздний заказ для каждого клиента
- применение фильтров к результирующему набору данных по условиям внутри функции
- для выполнения вычислений на группах данных. Не нужно создавать временные таблицы или подзапросы
- обращения к данным из других строк в пределах окна. Полезно для сравнения значений или расчета разницы между значениями
- Для сложных статистических расчетов (например, распределение значений, определение выбросов)
Дата последнего изменения: 14.09.2026
Если вы нашли ошибку, пожалуйста, выделите текст и нажмите Ctrl+Enter.