


 Скачать документ
Параллельная загрузка JSON из приложения на GO
Данный пример демонстрирует создание простейшей программы на языке программирования Go (Golang) с использованием стандартного пакета database/sql для работы с базами данных. Мы рассмотрим, как подключиться к базе данных, разобрать JSON данные из файла и добавить их в таблицы БД.
Что рассмотрено в примере? В ходе разработки мы:
- Подключимся к базе данных.
- Прочитаем записи в формате JSON из внешнего файла.
- Выполним их синтаксический разбор.
- Пакетно загрузим их в несколько таблиц БД.
Какие инструменты и технологии используются?
- Язык программирования: Go (Golang).
- Пакет для работы с базой данных: database/sql и драйвер для РЕД База Данных — github.com/nakagami/firebirdsql.
- СУБД: РЕД База Данных 5.
- Операционная система: Windows или Linux (на примере РЕД ОС).
Установка GoLang
ОС Windows
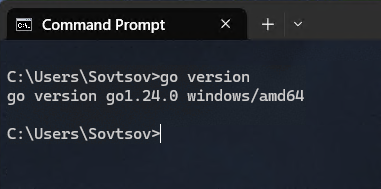
Linux
go --versionУстановка и настройка VS Code для работы на языке GoLang
sudo dnf install code- Запустить VS Code командой:
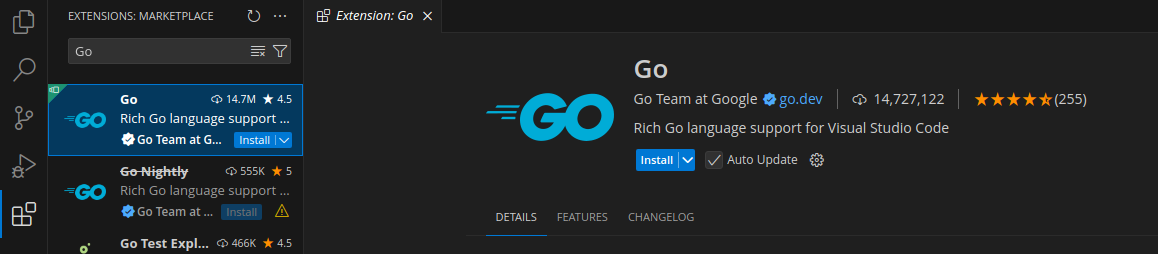
code- Перейдите во вкладку Extensions и в поиске введите Go и установите дополнение
Создание проекта
Linux
- Сначала нужно создать папку нашего проекта (он будет находиться в домашней директории)
mkdir ~/jsonloader- В папке проекта создадим файл main.go
- Инициализируем модуль Go
go mod init jsonloader- Откроем ее при помощи VS Code
code ~/jsonloader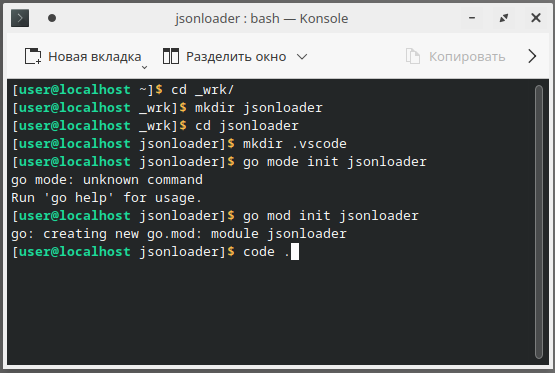
Windows
- Сначала нужно создать папку нашего проекта
- Откроем ее при помощи VS Code
- В папке проекта создадим файл main.go
- Инициализируем модуль Go
go mod init jsonloader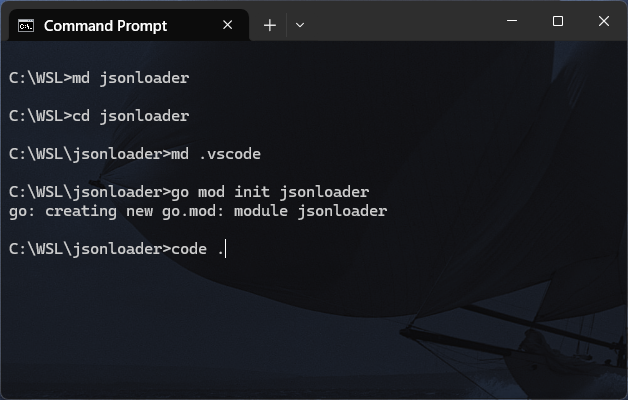
Далее
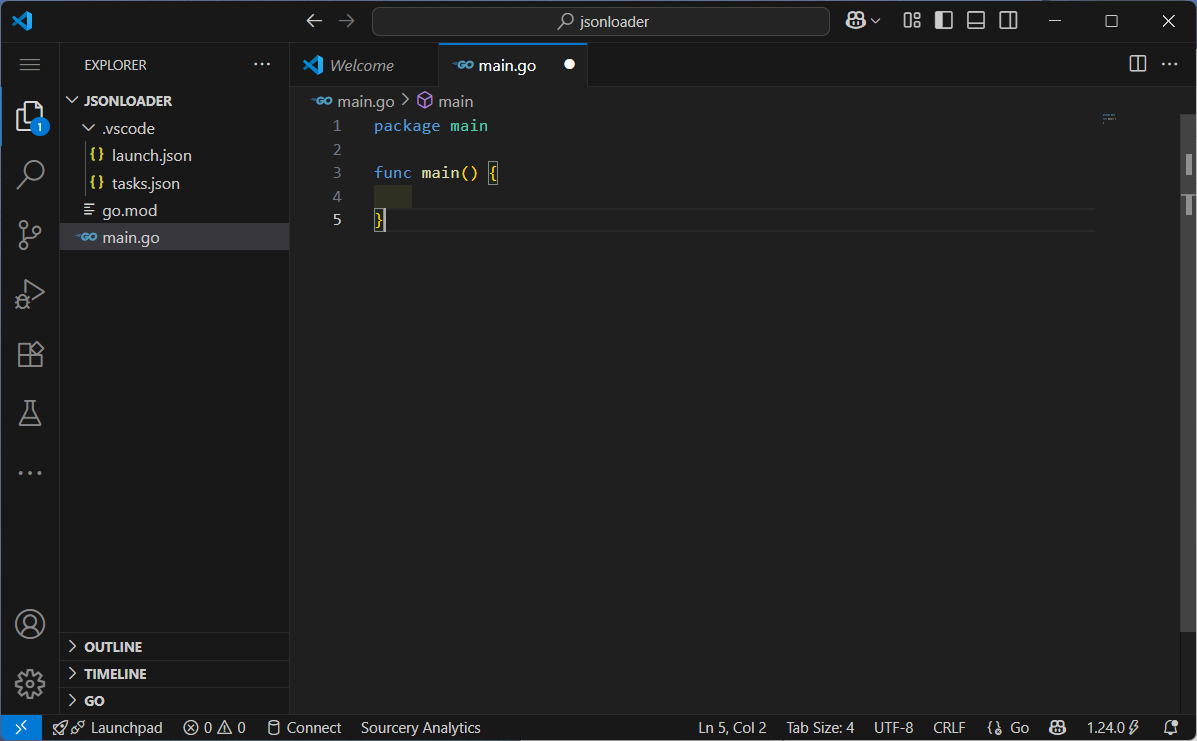
- Создадим новую папку в проекте и назовем ее .vscode (в ней будут храниться скрипты для сборки и запуска проекта для vscode)
- В папке .vscode создадим два файла launch.json и tasks.json
- В tasks.json запишем скрипт
   {
        "version": "2.0.0",
        "tasks": [
            {
                "label": "Build Go Project",
                "type": "shell",
                "command": "go",
                "args": ["build", "-o", "${workspaceFolder}/bin/"],
                "group": {
                    "kind": "build",
                    "isDefault": false
                },
                "problemMatcher": [],
                "detail": "Compile the Go project into a binary."
            },
            {
                "label": "Clean Build",
                "type": "shell",
                "command": "rm",
                "args": ["-rf", "${workspaceFolder}/bin"],
                "group": "build",
                "problemMatcher": [],
                "detail": "Clean up the bin directory."
            }
        ]
   }
Он будет выполнять 2 функции, собирать проект в папку bin и удалять собранные файлы.
- launch.json
{
    "version": "0.2.0",
    "configurations": [
        {
        "name": "Launch Project",
        "type": "go",
        "request": "launch",
        "mode": "debug",
        "program": "${workspaceFolder}",
        "env": {},
        "args": [
            "-u", "sysdba",
            "-p", "masterkey",
            "-H", "localhost:3050",
            "-dbpath", "NewDB.FDB",
            "-T", "SALES_REC (jsrc)",
            "-wks", "4",
            "/home/user/Tutorial/main/rdbtutorials/.main/input.json"
          ]
        }
    ]
}
Этот скрипт нужен для удобного запуска проекта.
Подключите библиотеку в main.go (теперь import должен выглядеть так)
   import (
    "database/sql"
    "fmt"
    "log"

    _ "github.com/nakagami/firebirdsql"
   )
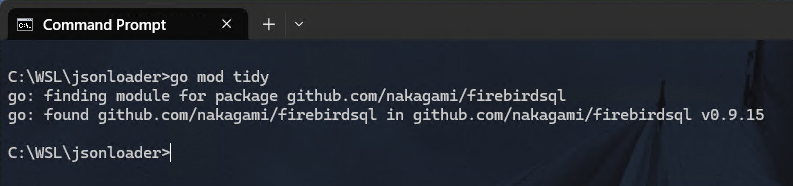
Загрузите нужную библиотеку
Теперь мы готовы к разработке функционала загрузчика.
Что должен уметь делать загрузчик?
Подавляющее большинство данных из внешней системы приходит в виде отчетов из системы на основе MongoDB в формате JSON — “родного” представления данных в MongoDB.
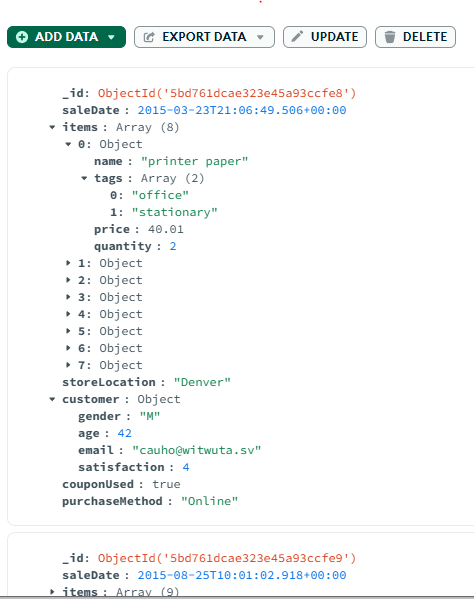
Входная порция внешних данных представляет собой файл, содержащий JSON-массив из большого количества JSON-объектов сложной структуры. Каждый объект соответствует одной записи о продаже.
Задача состоит в том, чтобы разобрать входной массив, и каждый объект из массива загрузить в виде поля отдельной записи в указанную таблицу демонстрационной БД SALES.
Полезно, если вызов загрузчика будет иметь следующий вид:
user@pc$ <loader> <параметры> <файл с загружаемыми данными>В качестве параметров нужны следующие данные:
- имя и пароль пользователя. Лучше всего, если пароль можно будет скрыть.
- имя/адрес хоста сервера СУБД
- порт для соединения с сервером
- путь к файлу БД на сервере
- имя таблицы БД и колонки, в которую будут загружены записи.
- при необходимости, другие
Реализация
Для работы с параметрами командной строки в Go стандартно используется пакет “flag”
import (
    "database/sql"
    "encoding/json"
    "flag"
    "fmt"
    "log"
    "os"
    "sync"
    "time"

    _ "github.com/nakagami/firebirdsql"
)

var SQLSTMT string = `INSERT INTO src_sales (JSRC) VALUES (?);`

func main() {

    // Declare flags with default values and help text
    user := flag.String("u", "sysdba", "пользователь")
    psw := flag.String("p", "mypsw", "пароль")
    verbose := flag.Bool("verbose", false, "разрешить подробности")
    dbpath := flag.String("dbpath", "c:/_data/_NewDB.FDB", "путь к файлу БД")
    hostport := flag.String("H", "localhost:3050", "Host & port для СУБД")
    dbtable := flag.String("T", "SALES_REC (jsrc)", "Таблица и колонка для загрузки")
    viaproc := flag.String("E", "", "Для теста процедуры")
    //, например: \"TABLE (fld_blob)\"
    wks := flag.Int("wks", 25, "Одновременных исполнителей")

    if len(os.Args) < 2 {
        fmt.Printf("Usage: %s <флаги> src_file\n", os.Args[0])
        flag.PrintDefaults()
        return
    }
    // Parse the command-line arguments
    flag.Parse()

    // Access the parsed values

    RDBconnStr := fmt.Sprintf("%s:%s@%s/%s", *user, *psw, *hostport, *dbpath)
    if *viaproc != "" {
        SQLSTMT = fmt.Sprintf("Call %s (?);", *viaproc)
    } else {
        SQLSTMT = fmt.Sprintf("INSERT INTO %s VALUES (?);", *dbtable)
    }
    verboseMod := *verbose
    if verboseMod {
        fmt.Println("Verbose mode is enabled.")
    }

    // Access any remaining positional arguments
    src_file := flag.Args()[0]
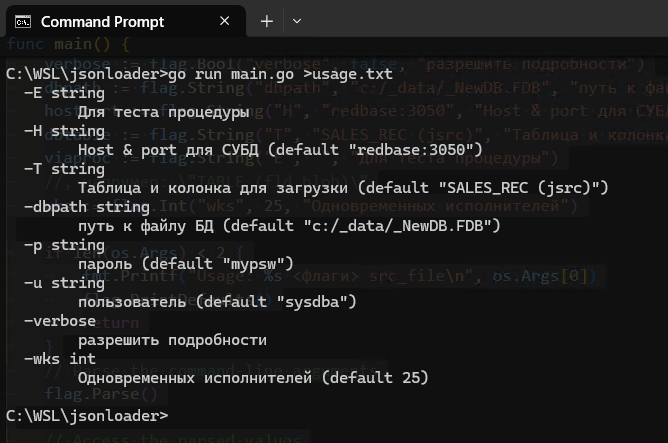
В этом фрагменте из main.go заданы имена флагов, их значения по умолчанию и краткие пояснения. В результате, при пропуске параметров или ошибке в них программа выдаст подсказку.
Средства встроенного пакета “encoding/json” позволяют выполнить разбор синтаксиса JSON-файла с данными и передать результаты разбора в переменные в памяти.
В данном случае задача несколько упрощается, так как окончательный разбор объектов JSON будет выполнять SQL/JSON на сервере СУБД РЕД База Данных.
Поэтому в программе разбирается только массив верхнего уровня, а объекты из него помещаются в слайс recs в формате “сырого” JSON.
  // Read json file
    file, err := os.Open(src_file)
    if err != nil {
        log.Fatalf("unable to read file: %v", err)
    }
    defer file.Close()
    log.Println("Данные получены из:", src_file)

    var recs []json.RawMessage // Declare a slice of your struct type

    // Decode JSON file
    decoder := json.NewDecoder(file)
    // fmt.Println("decoder created")

    err = decoder.Decode(&recs)
    if err != nil {
        log.Fatalf("Error decoding JSON: %v", err)
    }
    fmt.Printf("Раскодированы %d записи(ь)\n", len(recs))

    // Now 'recs' contains the data from your JSON array
Соединяемся с БД. При неудаче завершаем программу с кодом ошибки.
    // RDBconnStr собирается из параметров *user, *psw, *hostport, *dbpath
    db, err := sql.Open("firebirdsql", RDBconnStr)
    if err != nil {
        log.Fatal(err)
    }
    defer db.Close()

    // Теперь БД открыта и готова для работы
Функция, выполняющая непосредственную вставку в таблицу БД порции данных из множества записей:
func processBatch(db *sql.DB, data []json.RawMessage) error {
    var tx *sql.Tx
    var err error
    tx, err = db.Begin()
    if err != nil {
        // fmt.Println(fmt.Errorf("failed to begin transaction: %w", err))
        return fmt.Errorf("failed to begin transaction: %w", err)
    }
    // fmt.Println("Transaction started")
    for i, item := range data {
        // Perform your database operation using tx
        rec := string(item)
        _, err = tx.Exec(SQLSTMT, rec)
        if err != nil {
            // Rollback on error
            tx.Rollback()
            // fmt.Println("Rollback")
            return fmt.Errorf("ROLLBACK:failed to insert item (%d) %s: %w", i, rec[11:51], err)
        }
    }
    // Конец порции
    err = tx.Commit()
    if err != nil {
        return fmt.Errorf("failed to commit transaction: %v", err)
    }
    // log.Printf("Commited after %d\n", len(data))
    return nil
}
Функция получает на вход открытое соединение с БД и массив записей для вставки в БД. Возвращает ошибку или nil в случае успеха. В самом начале открывает новую транзакцию БД. Затем для каждой записи из массива выполняет SQLSTMT (который был сформирован из шаблона и значения флага -T ) При неудаче выполняется откат (Rollback) всей транзакции. После успешной загрузки последней записи из переданного массива выполняется фиксация (Commit) открытой транзакции. Работа с транзакциями, Commit, Rollback реализована во встроенном пакете "database/sql".
Транзакции - необходимый, но достаточно затратный по времени и ресурсам инструмент СУБД. Поэтому открытие и фиксация транзакции не после каждой записи, а после целого пакета (порции входных данных) ускоряет загрузку. Но есть способ сократить время еще больше.
Язык Go известен развитыми и эффективными средствами параллельного выполнения кода. Для этого служат горутины и каналы данных, использование которых дает нам возможность таким образом сконструировать программу, чтобы загрузка прошла за минимальный отрезок времени. Применим паттерн параллельного выполнения “Set of Workers” (“группа рабочих”).
// "Рабочий"

type Task struct {
    jobnum int               //номер порции
    jdata  []json.RawMessage //порция данных
    lowB   int               //не используется
    highB  int
}

func worker(in chan Task, workerId int, db *sql.DB, wg *sync.WaitGroup) {
    for received := range in {
        err := processBatch(db, received.jdata)
        if err != nil {
            log.Fatalf("wkr: %d, goroutine Error: %v", workerId, err)
        }
    }
    // Когда канал закрыт происходит выход из цикла for
    // log.Printf("worker %d закончил", workerId)
    wg.Done()
}
Структура Task (“задание“) является единицей передачи данных по входному каналу “рабочему” (функции “worker“). Также ему передается его workerId (для диагностики), соединение с БД, через которое он должен выполнять свою работу, и группу синхронизации.
Пока в канале есть для него задания, рабочий запускает функцию вставки записей с порцией данных из очередного задания.
За управление делением данных на порции, помещением в канал “заданий” и созданием “рабочих” отвечает главная процедура main.
Количество “рабочих” - параллельно работающих заданий - указывается в параметрах строки запуска. Все данные делятся на указанное количество порций и помещаются в канал jobCh. “Рабочий” забирает задание из канала и обрабатывает его.
// Создание заданий
    numberOfWorkers := *wks //из командной строки
    w8 := sync.WaitGroup{}
    w8.Add(numberOfWorkers)

    jobCh := make(chan Task, numberOfWorkers+1)

    // создание группы worker
    for k := range numberOfWorkers {
        go worker(jobCh, k, db, &w8)
    }

    // выдача заданий
    inLen := len(recs)

    batchLast := -1
    batchSize := inLen / numberOfWorkers

    if batchSize > 0 {
        batchLast = inLen % batchSize
    } else {
        batchLast = inLen
    }
    fmt.Printf("Объем=%d jobs=%d порция=%d остаток=%d\n", inLen, numberOfWorkers,
        batchSize, batchLast)

    for lowb, job := inLen, 0; lowb > 0; lowb, job = lowb-batchSize, job+1 {
        lb := max(lowb-batchSize, 0)
        jobCh <- Task{
            jobnum: job,
            jdata:  recs[lb:lowb],
            lowB:   lb,
            highB:  lowb,
        }
    }

    // сообщаем, что новых заданий в канал не поступит
    close(jobCh)
    // ждем завершения всех заданий
    w8.Wait()
Весь проект с исходными текстами можно взять из прилагаемого архива
Для компиляции в исполняемый модуль выполните команду в окне терминала
go build -o "./bin/" -trimpathили непосредственно из VSCode:
нажать Ctrl-Shift-B
Из выпадающего списка выбрать пункт Build Go Project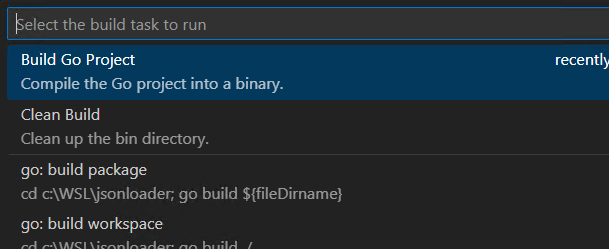
Первичные результаты
Скорость работы программы может зависеть от множества факторов. На разном оборудовании результат может сильно отличаться. Сравнительные замеры выполнялись в рамках единого имеющегося тестового стенда, который состоит из клиентского ноутбука, где компилировалась программа и хранились внешние данные, и виртуальной машины с Windows 10 - сервера СУБД с РЕД База Данных 5.0.
- Без использования средств параллельной обработки Go среднее время загрузки 5000 записей превысило 40 секунд.
- В параллельном режиме среднее время загрузки файла с 5000 записей оказалось около 4.5 секунд. Наименьшее время достигается при “группе рабочих” размером 25-33.
На другом оборудовании результат может отличаться как в одну, так и в другую сторону.
Дата последнего изменения: 11.09.2026
Если вы нашли ошибку, пожалуйста, выделите текст и нажмите Ctrl+Enter.