


 Скачать документ
Разбор входных данных и загрузка в связанные таблицы
Итак, вся порция новых данных загружена на сервер БД в таблицу SALES, которая содержит колонку ID — первичный ключ с автоинкрементом и два длинных текстовых поля JVAR и JSRC. В них загружены одинаковые входные записи в разных типах представления — varchar и BLOB SUB_TYPE TEXT. Это было сделано для демонстрации возможности применения varchar, если хватает имеющихся ограничений на размер.
Таблица — временная: после разбора содержащихся в ней данных и занесения в основные таблицы аналитической БД ее можно (а перед загрузкой новой порции данных — необходимо) полностью очистить.
Разбор и загрузка JSON c хранимыми процедурами
Какую стратегию разбора и обработки данных стоит выбрать?
SQL оперирует наборами данных - множествами записей. Операции выборки в большинстве случаев возвращают множество записей в ответ на запрос. Основные операции объединения и пересечения выборок на основе разных критериев - предназначены для работы с множествами записей. Это одно из основных достоинств SQL, большинство реляционных СУБД прекрасно справляются с этими операциями и задачами. В то же время операторы PSQL для обхода каждой записи выборки могут работать значительно медленнее.
Однако на очень больших объемах данных и размерах выборок для операций над наборами данных приходится использовать индексы, партиционирование и другие хитрые приемы, чтобы добиться минимальных времен отклика. Возможности применения этих приемов могут быть ограниченными, чтобы обеспечить хорошее быстродействие системы в целом, а не только конкретного запроса.
В этом примере рассматриваются оба варианта.
Работа с множествами
Если выбрать множественный подход, то последовательность действий обработки всего входного массива будет примерно такой:
сделать запрос по всей таблице SALES, разобрать формат JSON, чтобы выделить ту часть информации из каждой записи, которая относится к покупателю (“customer”: {…}).
отобрать всех уникальных покупателей.
обновить таблицу CUST записями из этой выборки, которые пока отсутствуют в CUST.
сделать другой запрос по всей таблице SALES, разобрать формат JSON, выделить часть информации о продаже.
сделать JOIN с таблицей CUST для получения ссылки на запись о покупателе.
добавить все записи из выборки в таблицу SALE_RECORDS.
сделать другой запрос по всей таблице SALES, разобрать формат JSON, выделить данные из массива о продуктах, вошедшие в данную продажу ( {“items”:[ {“name”:”paper”, …} ] }) плюс внешний идентификатор продажи OID
сделать JOIN по OID с таблицей SALE_RECORDS, чтобы получить ссылку на актуальную запись о продаже
добавить все записи из выборки в таблицу ITEMS
В примере в таблице SALES содержится 5000 входных записей. Предположим, что среди них только 1000 новых покупателей. Присутствие покупателя должно проверяться по совпадению всех 3 полей: EMAIL, AGE, GENDER. Даже при наличии уникального индекса по этим полям, такая проверка идет для такого массива довольно медленно.
Аналогично со списком проданных товаров. С учетом того, что в каждой входящей записи описана продажа нескольких товаров, число входных записей для добавления в ITEMS увеличилось до 27500, так что пересечение для получения ссылки на актуальную добавленную запись о продаже может занять длительное время, даже при наличии индекса.
Без сомнения, можно найти более быстрый вариант.
Разбор и обработка записей по одной
Рассмотрим вариант с разбором и обработкой записей по одной.
Общая последовательность обработки практически совпадает с описанной выше, за исключением отсутствия необходимости делать JOIN между большими выборками. Оператор INSERT после выполнения добавления записей возвращает ID только что добавленной записи, который можно использовать для ссылки в записях про товары. Это существенно проще и намного быстрее, однако такие операции нужно повторить много раз - по количеству записей во входной таблице.
Для обработки каждой входной записи создана хранимая процедура IMPORT_SALE_JSON.
CREATE OR ALTER PROCEDURE IMPORT_SALE_JSON (
    SALE_INFO VARCHAR(8191)
)
AS
DECLARE cust_id bigint;
DECLARE srec_id bigint;
DECLARE sale_oid varchar(100);
DECLARE sale_date varchar(140);
DECLARE purchasevia varchar(50);
DECLARE storelocation varchar(100);
DECLARE withcoupon boolean;
DECLARE email varchar(200);
DECLARE gender char(5);
DECLARE age int;
DECLARE satisfacted int;
DECLARE it_name varchar(100);
DECLARE it_tags varchar(200);
DECLARE quantity int;
DECLARE price decimal(12,2);
BEGIN
 -- Проверка на валидность JSON
 IF (:sale_info IS NULL) THEN
 BEGIN
 EXCEPTION EMPTY_INPUT;
 END

    for
    select first 1
        jt.sale_date,
        jt.purchasevia,
        jt.storelocation,
        jt.withcoupon,
        jt.oid,
        jt.email,
        jt.gender,
        jt.age,
        jt.satisfacted
    FROM
        JSON_TABLE(
        :sale_info,
        'lax $' COLUMNS (
            sale_date varchar(140) path '$.saleDate."$date"' null ON EMPTY ERROR ON ERROR,
            purchasevia varchar(50) path '$.purchaseMethod' null ON EMPTY ERROR ON ERROR,
            storelocation varchar(100) path '$.storeLocation' null ON EMPTY ERROR ON ERROR,
            withcoupon boolean path '$.couponUsed' null ON EMPTY ERROR ON ERROR,
            oid varchar(100) path '$."_id"."$oid"' ERROR ON EMPTY ERROR ON ERROR,
            NESTED PATH '$.customer[0]' COLUMNS (
                email varchar(200) path '$.email',
                gender char(5) path '$.gender',
                age int path '$.age',
                satisfacted int path '$.satisfaction'
            )
        )
    ) as jt
    into
        :sale_date,
        :purchasevia,
        :storelocation,
        :withcoupon,
        :sale_oid,
        :email,
        :gender,
        :age,
        :satisfacted
    DO
    BEGIN
        /*
           Обновление списка покуптелей CUST
        */
        select c.ID from cust c where
        (c.email=:email and c.gender=:gender and c.age=:age)
        into :cust_id ;

        IF (:cust_id is Null) THEN BEGIN
            insert into CUST (email, gender , age)
            values (:email, :gender , :age)
            returning id into :cust_id;
        END

    /* ССылка на запись покупателя теперь в :CUST_ID  */

    IF (EXISTS (
        select 1 from SALE_RECORDS where OID = :sale_oid
    ))
    THEN
    BEGIN
        select srec_id from SALE_RECORDS where OID = :sale_oid
        into :srec_id;
    END
     ELSE
     BEGIN
        INSERT into SALE_RECORDS (
        SALE_DATE, PURCHASEVIA, STORELOCATION, WITHCOUPON, CUST_REF, SATISFACTED, OID
        ) VALUES (
            cast( left( replace(:sale_date,'T',' '),char_length(:sale_date)-1) as timestamp),
            :purchasevia, :storelocation, :withcoupon, :cust_id, :satisfacted, :sale_oid
         )
         returning srec_id into :srec_id ;
     END
    END

    /* Ссылка на запись о продаже теперь в :SREC_ID  */

    IF (NOT (EXISTS (
        SELECT 1 FROM ITEMS IT WHERE it.SALE_REF = :srec_id
    )))
    THEN
    BEGIN
        FOR
        SELECT
            jt.it_name,
            jt.it_tags,
            jt.quant,
            jt.price
        FROM
        JSON_TABLE(
         :sale_info,
        'lax $' COLUMNS (
            NESTED PATH 'lax $.items[*]' AS SUBIt COLUMNS (
            it_name varchar(100) PATH '$.name',
            it_tags varchar(200) format json PATH '$.tags[*]' WITH ARRAY wrapper,
            quant int PATH '$.quantity' DEFAULT '-1' ON ERROR --DEFAULT '0' ON EMPTY
            , NESTED PATH '$.price' COLUMNS (
                price decimal(12, 2) PATH '$."$numberDecimal"' DEFAULT '-1' ON ERROR
              )
            )
          )
        ) AS jt
        INTO
            :it_name,
            :it_tags,
            :quantity,
            :price
        DO
        BEGIN
            INSERT into ITEMS (
            SALE_REF,
            IT_NAME, IT_TAGS, IT_QUANT, IT_PRICE
            ) VALUES (
            :SREC_ID,
            :it_name, :it_tags, :quantity, :price
            );
        END
    END
END;
Как это работает?
Процедура получает строку с JSON текстом через единственный входной параметр типа VARCHAR(8191). Это максимальная длина строки для кодировки UTF8. В данном примере этого хватает, но можно переопределить его как домен JSON.
CREATE DOMAIN JSON AS BLOB SUB_TYPE TEXT;
Если параметр не содержит строку (она пустая), возвращается прерывание.
Определяется набор внутренних переменных для хранения данных из разобранного JSON.
Далее следует разбор JSON из этой строки, добавление полученной при разборе информации в таблицы БД.
Для разбора применяется SQL/JSON.
Чтобы правильно разобрать JSON данные, необходимо заранее знать структуру входящей JSON-записи или объекта.
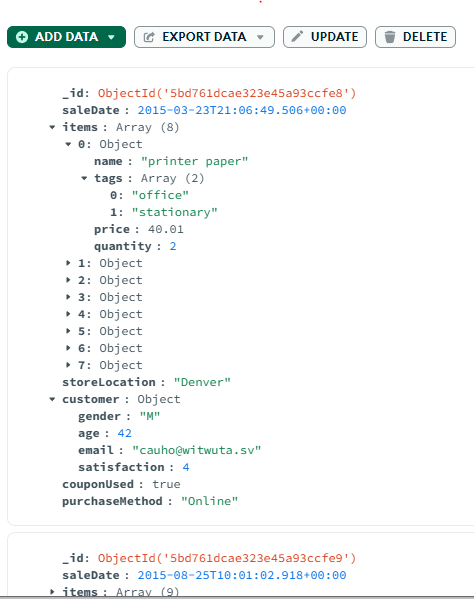
Здесь представлена структура каждого объекта из входного массива.
Во фрагменте ниже
        select first 1
            jt.sale_date,
            jt.purchasevia,
            jt.storelocation,
            jt.withcoupon,
            jt.oid,
            jt.email,
            jt.gender,
            jt.age,
            jt.satisfacted
        FROM
            JSON_TABLE(
              :sale_info,
              'lax $' COLUMNS (
                        sale_date varchar(140) path '$.saleDate."$date"' null ON EMPTY
                        ERROR ON ERROR,
                        purchasevia varchar(50) path '$.purchaseMethod' null ON EMPTY
                        ERROR ON ERROR,
                        storelocation varchar(100) path '$.storeLocation' null ON
                        EMPTY ERROR ON ERROR,
                        withcoupon boolean path '$.couponUsed' null ON EMPTY ERROR ON ERROR,
                        oid varchar(100) path '$."_id"."$oid"' ERROR ON EMPTY ERROR ON ERROR,
                        NESTED PATH '$.customer[0]' COLUMNS (
                            email varchar(200) path '$.email',
                            gender char(5) path '$.gender',
                            age int path '$.age',
                            satisfacted int path '$.satisfaction'
                        )
                    )
            ) as jt
        into
            :sale_date,
            :purchasevia,
            :storelocation,
            :withcoupon,
            :sale_oid,
            :email,
            :gender,
            :age,
            :satisfacted
SELECT разбирает входную строку из параметра процедуры sale_info в соответствии с указанной выше структурой. Выделяются все данные, кроме перечня товаров, проданных в рамках данной продажи, в том числе из вложенного объекта “customer”. Полученные данные помещаются в соответствующие переменные.
Конструкция SQL
FOR SELECT
...
DO BEGIN
...
END
позволяет выполнить целый блок действий для каждой записи из результирующего набора
В данном случае:
        /*
           Обновление списка покупателей CUST
           - ищется покупатель с такими же значениями полей.
           - Если он найден, сохраняется его cust_id в переменной с тем же именем
           - Если такого не нашлось - добавляется новая запись и в переменной сохраняется
           уже ее идентификатор
        */
          select c.ID from cust c where
            (c.email=:email and c.gender=:gender and c.age=:age)
          into :cust_id ;

          IF (:cust_id is Null) THEN BEGIN
            insert into CUST (email, gender , age)
                values (:email, :gender , :age)
                        returning id into :cust_id;
          END

          /* Ссылка на запись покупателя теперь в :CUST_ID  */
Далее проверяется наличие в БД текущей записи о продаже (по уникальному идентификатору из БД MongoDB - типа OID) [1]
Если такая есть, то сохраняется ее идентификатор srec_id, если такая отсутствует - добавляется новая запись с полученными значениями, и сохраняется уже ее идентификатор для ссылки.
Здесь пришлось выполнить некоторые операции со значением поля SALE_DATE для перевода ее из символьного формата в стандарте ISO в тип данных TIMESTAMP СУБД РЕД База Данных.
    IF (EXISTS (
        select 1 from SALE_RECORDS where OID = :sale_oid
    ))
    THEN
    BEGIN
        select srec_id from SALE_RECORDS where OID = :sale_oid
        into :srec_id;
    END
     ELSE
     BEGIN
        INSERT into SALE_RECORDS (
        SALE_DATE, PURCHASEVIA, STORELOCATION, WITHCOUPON, CUST_REF, SATISFACTED, OID
        ) VALUES (
            cast( left( replace(:sale_date,'T',' '),char_length(:sale_date)-1) as timestamp),
            :purchasevia, :storelocation, :withcoupon, :cust_id, :satisfacted, :sale_oid
         )
         returning srec_id into :srec_id ;
     END
    END

    /* Ссылка на запись о продаже теперь в :SREC_ID  */
Наконец, идет обработка массива строк о товарах, участвовавших в данной продаже.
Только в том случае, если в таблице ITEMS отсутствуют записи, относящиеся к данной продаже, с помощью SQL/JSON разбирается массив “items” из входной строки, и добавляются новые записи, ссылающиеся на актуальную запись о продаже.
IF (NOT (EXISTS (
        SELECT 1 FROM ITEMS IT WHERE it.SALE_REF = :srec_id
    )))
    THEN
    BEGIN
        FOR
        SELECT
            jt.it_name,
            jt.it_tags,
            jt.quant,
            jt.price
        FROM
        JSON_TABLE(
         :sale_info,
        'lax $' COLUMNS (
            NESTED PATH 'lax $.items[*]' AS SUBIt COLUMNS (
            it_name varchar(100) PATH '$.name',
            it_tags varchar(200) format json PATH '$.tags[*]' WITH ARRAY wrapper,
            quant int PATH '$.quantity' DEFAULT '-1' ON ERROR --DEFAULT '0' ON EMPTY
            , NESTED PATH '$.price' COLUMNS (
                price decimal(12, 2) PATH '$."$numberDecimal"' DEFAULT '-1' ON ERROR
              )
            )
          )
        ) AS jt
        INTO
            :it_name,
            :it_tags,
            :quantity,
            :price
        DO
        BEGIN
            INSERT into ITEMS (
            SALE_REF,
            IT_NAME, IT_TAGS, IT_QUANT, IT_PRICE
            ) VALUES (
            :SREC_ID,
            :it_name, :it_tags, :quantity, :price
            );
        END
    END
Процедура загрузки готова.
Осталось продумать еще пару вопросов:
- Как обеспечить вызов процедуры для каждой записи из временной таблицы SALES?
- Как действовать если что-то пошло не так?
- Про автоматизацию загрузки
- Может не сработать в другом примере.↩︎
Дата последнего изменения: 11.09.2026
Если вы нашли ошибку, пожалуйста, выделите текст и нажмите Ctrl+Enter.